Fallstricke beim Deployen von LLMs in sensiblen Umfeldern
2026-09-12
Warum dein KI-Projekt nicht am Modell scheitert, sondern an allem, was davor kommt. Sonst schreibe ich darüber, welcher Schmerz danach auftauchen kann, wie bspw. beim Audit. Diesmal kommen wir gar nicht erst so weit: Deployment-Schmerzen. Ich halte es da wie beim Kampfsport: no pain, no gain. Hübsche Demos und glattpolierte Prototypen dürfen andere zeigen. Der Happy Path ist für Weicheier.
Kurze Vorbemerkung, damit die Erwartung stimmt: Hier geht es allen voran um die Lücke zwischen „Das (Azure-)Portal sagt fertig“ und einer KI-Plattform, die unter realen Sicherheits- und Betriebsanforderungen tatsächlich funktioniert. ClickOps verführt dich zu glauben, dass das in 10 Minuten erledigt sei: ein paar bunte Buttons, grüne Häkchen, fertig ist die Laube. Wie früher bei Visual Basic …
Nur beweist eine angelegte Ressource noch nicht, dass deine Pipeline sie erreicht, die richtige Identität darauf zugreifen darf oder du das Ganze reproduzierbar bis nach Prod bekommst. Dafür brauchst du Storage Accounts, DNS-Zonen, Service Principals und mehr als einen erfolgreichen Klickfinger.
Diese Liste ist aus Schmerz geboren, nicht aus KI-generiertem Oberflächenwissen.
Betrete mit mir das Dojo:
„Nine Chambers of LLM-Ops-Shaolin“.
1. DAS MODELL IST DIE EINFACHSTE RESSOURCE IM GANZEN STACK
Azure AI Foundry, ein Projekt, ein Modell-Deployment: Das klickt jede:r im Portal zusammen. Der eigentliche Aufwand beginnt davor , nämlich in der Plattform, die den Betrieb überhaupt erst möglich macht:
- Hub/Spoke-Architektur mit zentraler Firewall, bei der jede Egress-Freigabe einen Prozess durchlaufen muss
- zentrale Private-DNS-Zonen, die ein anderes Team besitzt und die erst verlinkt werden müssen
- ein Private-Endpoint-Subnetz, dessen CIDR-Range vorab reserviert werden muss
- eine Deploy-Identität mit exakt den benötigten Rechten und keinen darüber hinaus
- ein Key Vault mit kundenseitigem HSM-Schlüssel, der von Dritten bereitgestellt und betrieben wird
Wer das als „KI-Projekt“ plant, unterschätzt den Aufwand typischerweise um Faktor 5. Es ist ein Plattformprojekt mit einem KI-Baustein oben drauf. Die ehrliche Reihenfolge lautet: erst Plattform-Contract, dann Terraform, dann Modell.
2. DREI GETRENNTE PRÜFUNGEN, UND EIN GRÜNER PUNKT ERSETZT DIE ANDEREN BEIDEN NICHT
Der häufigste Denkfehler in Statusmeetings lautet: „Der Zugriff funktioniert.“ und niemand fragt nach, welcher Zugriff gemeint ist.
Ich zerlege die Frage deshalb konsequent in drei separate Prüfungen:
- Identität: Wer meldet sich bei Azure an — du mit deinem Admin-Konto, die Deployment-Pipeline mit ihrem Service Principal oder die laufende Anwendung mit ihrer Managed Identity? Das sind getrennte Identitäten. Deine Pipeline erbt deine Admin-Rechte nicht durch emotionale Nähe zum Entwickler. Wenn du dich per
az loginmit deinem Benutzerkonto anmeldest und erfolgreich testest, hast du zunächst nur deinen eigenen Zugang getestet. Ob die Pipeline sich mit ihrer vorgesehenen Identität authentifizieren kann, ist damit völlig offen. Deshalb: die Anmeldung mit genau der Identität und dem Authentifizierungsverfahren prüfen, die später tatsächlich zum Einsatz kommen. Wer bist du? ist diese Prüfung. Was darfst du? kommt im nächsten Schritt. - RBAC am richtigen Scope: Azure weiß jetzt, wer du bist. Daraus folgt noch nicht, dass du etwas darfst. Bei der rollenbasierten Zugriffskontrolle (RBAC) zählen zwei Dinge: Welche Aktion erlaubt die Rolle und wo gilt die Zuweisung? Dieser Geltungsbereich heißt Scope: Management Group, Subscription, Resource Group oder einzelne Ressource. Berechtigungen werden nach unten vererbt, nicht nach oben. Reader auf einer Subscription verschafft dir deshalb nicht automatisch Leserechte auf der Management Group darüber, auch dann nicht, wenn deren Policies dein Deployment blockieren. Und Contributor auf deiner Resource Group erlaubt dir, Ressourcen zu verwalten, aber nicht, anderen Identitäten Azure-Rollen zuzuweisen. Du darfst die Halle bauen, aber nicht die Schlüssel verteilen. Wenn Terraform beides erledigen soll, braucht die Deploy-Identität auch die passende Berechtigung für Rollenzuweisungen am vorgesehenen Scope. Deshalb nicht fragen: „Haben wir Contributor?“, sondern: „Darf genau diese Identität genau diese Aktion an genau dieser Ressource ausführen?“ (Microsoft Learn: Azure RBAC)
- Netzpfad: Deine Identität stimmt, die Berechtigungen passen. Jetzt muss deine Anfrage die Ressource auch noch erreichen. Azure trennt dabei Verwaltung und Nutzung: Über die Control Plane (Azure Resource Manager, kurz ARM) legst du beispielsweise einen Storage Account an oder liest seine Konfiguration. Über die Data Plane greifst du auf die eigentlichen Inhalte und Funktionen zu: einen Blob lesen, ein Secret aus dem Key Vault abrufen, das Modell aufrufen. Das sind unterschiedliche Endpunkte. Dass die CLI deinen Storage Account auflistet, beweist deshalb nicht, dass Terraform die darin gespeicherte State-Datei erreichen kann. Du hast beim Empfang angerufen. Noch lange nicht den Tresor geöffnet.
Ist der Blob-Zugriff ausschließlich über einen Private Endpoint vorgesehen, muss der Storage-Hostname aus dem ausführenden System auf die richtige private IP-Adresse aufgelöst werden. Anschließend müssen Routing und Netzwerkregeln die Verbindung dorthin erlauben. Fehlt die passende DNS-Auflösung, landet die Anfrage möglicherweise am öffentlichen Endpunkt oder findet gar kein Ziel. Fehlt der Netzweg, hilft auch die richtige IP nichts.
Deshalb vom tatsächlichen Ausführungsort testen: Laptop, Pipeline-Agent oder Anwendung. Welchen Endpunkt spreche ich an, welche IP liefert DNS dort zurück und kommt die Verbindung zustande? Ein grüner Test auf deinem Laptop baut der Pipeline keinen Tunnel. (Microsoft Learn: Control Plane und Data Plane; Private-Endpoint-DNS)
3. „GELIEFERT" IST NICHT „FUNKTIONIERT”
In verteilten Setups (Plattformbetreiber, interne IT, Projektteam, externe Forschung) entsteht ein Vokabularproblem.
Jemand meldet „Storage Account erstellt". Was heißt das? Existiert er? Hat die richtige Identität Rechte? Ist er aus dem Netz erreichbar, aus dem die Pipeline läuft?
Ich führe inzwischen eine Bestandsakte mit fünf Zuständen:
| Zustand | Bedeutung |
|---|---|
| ENTSCHIEDEN | Es gibt einen Beschluss. Sonst nichts. |
| CODE | Es steht im Terraform. Syntax-validiert ist kein Plan, Plan ist kein Apply. |
| GELIEFERT | Jemand meldet schriftlich die Anlage. Kein Ende-zu-Ende-Nachweis. |
| BELEGT | Im Ressourcenexport oder in konkreter CLI-Ausgabe sichtbar, mit Datum. |
| OFFEN | Fehlender Wert, fehlende Entscheidung, fehlender Test. |
Klingt bürokratisch. Ist aber der Unterschied zwischen „wir sind fast fertig" und „wir haben noch keinen einzigen erfolgreichen terraform init gegen den Remote State".
Beides kann am selben Tag wahr sein. Und ja: Ein grüner Kasten im Architekturdiagramm ist kein Deploymentstatus.
4. STATE, IDENTITÄT, SECRETS: DIE TERRAFORM-HAUSAUFGABEN
Eine Podcast-Folge der „Cloud Optimizer“ (Matthias Braun, Christian Forjahn) bringt es auf den Punkt: Viele Terraform-Projekte scheitern, bevor der erste apply-Lauf überhaupt möglich ist. In sensiblen Umfeldern kommt typischerweise noch Folgendes dazu:
- Remote State ist ein Kronjuwel. Er enthält Ressourcen-IDs, Outputs und nicht selten heikle Details bis hin zu Klartext. Deshalb: Shared Key deaktivieren, Zugriff nur über Entra-Authentifizierung. Versioning aktivieren. Soft Delete aktivieren. Wer Soft Delete vergisst, lernt es beim ersten versehentlich gelöschten State-Blob. Und: State-Storage ist kein App-Storage; getrennte Resource Group, eigener Lebenszyklus.
- Bootstrap sauber lösen ⇒ einmal, reproduzierbar. Wer legt den State-Storage an, wenn es noch keinen State gibt? Das Bootstrap-Dilemma löst du einmal sauber per Skript im Repo (oder einem dedizierten Bootstrap-Step); nicht per Portal-Klick, den in drei Monaten niemand mehr rekonstruieren kann.
- Keine Client Secrets. Für die Pipeline Workload Identity Federation. Pro Umgebung ein eigener Deploy-Principal mit Custom Role statt pauschal Contributor auf der Subscription. Ein Secret, das nach zwölf Monaten abläuft, zerlegt dir die Prod-Pipeline garantiert nachts.
- Subscription ist Konfiguration, nicht Bauchgefühl. Die Subscription gehört als Variable in den Provider; nicht als „die, in der ich gerade eingeloggt bin“. Das ist das Sicherheitsnetz gegen den Klassiker „Oops, falsche Subscription“. Bei 2 Subscriptions namens Test und Prod ist das kein theoretisches Risiko.
5. DIE POLICY, DIE DICH BLOCKT, DARFST DU NICHT LESEN
Das ist der fieseste Fallstrick in Enterprise-Landing-Zones: Azure Policy wird auf Management-Group-Ebene zugewiesen, aber dein Projektkonto darf die Assignments auf den übergeordneten Ebenen oft nicht lesen. Ergebnis: terraform plan bleibt grün, weil der Plan nur deine Konfiguration bewertet. Der apply scheitert dann mitten im Deployment an einem Deny, dessen Ursache du weder siehst noch sauber nachweisen kannst.
Abhilfe: Vor dem ersten produktionsnahen Apply vom Plattformteam einen Policy-Export einfordern ⇒ mindestens Assignments, Parameter, Exemptions und Enforcement Mode. Neuere Provider-Versionen verlagern mit „Preflight Validation“ einzelne Checks in den Plan, aber darauf kannst du dich nicht verlassen: Ohne Transparenz der Landing Zone bleibt es Stückwerk.
Gleiche Kategorie, anderer Hebel: Customer Managed Keys. Entscheidet der Kunde, dass Ressourcen mit einem HSM-Schlüssel zu verschlüsseln sind, gilt das auch für Smoke Tests mit synthetischen Daten. „Sind doch nur Testdaten“ ist keine Ausnahme. Entweder du holst sie schriftlich, oder du baust den CMK-Pfad zuerst.
ACHTUNG!
CMK und Customer Lockbox sind unterschiedliche Kontrollen. Das eine aktiviert das andere nicht.
6. DRIFT ENTSTEHT IM INCIDENT, UM DREI UHR NACHTS
Portal-Klicks im Incident sind nachvollziehbar, sie sind aber genau der Ursprung von Drift. Wer nachts in Prod „nur kurz“ einen Schalter umlegt, erzeugt fast zuverlässig eine zweite Störung: Beim nächsten Terraform-Apply wird die Änderung zurückgedreht, weil sie nicht im Code steht.
Die Konsequenz ist banal und trotzdem selten sauber umgesetzt:
- Portal-Änderungen in Prod verhindern. Azure Policy im Deny-Modus ist hier kein Governance-Accessoire, sondern Betriebsschutz (z. B. kein Public Endpoint, keine Klartext-Secrets, keine ungetaggten Ressourcen).
- Plan und Apply strikt trennen. Freigegeben wird ein konkreter Plan als Artefakt. Der Apply führt exakt diesen Plan aus — nicht „den aktuellen Stand“ und nicht „was gerade im Repo liegt“.
7. STAGING IST KEIN DATENSCHUTZRECHTLICHER FREIHAFEN
„Wir haben die Namen ersetzt.“ Schön. Damit hat dein Datensatz erst einmal einen falschen Schnurrbart. Ob er anonym ist, steht auf einem anderen Blatt.
Pseudonymisierung bedeutet: Die Daten lassen sich ohne zusätzliche Informationen nicht mehr einer bestimmten Person zuordnen. Aus „Anna Müller“ wird beispielsweise „Person 4711“; die Zuordnungstabelle wird getrennt aufbewahrt und technisch wie organisatorisch geschützt. Wer die Zusatzinformationen heranziehen kann, kann den Personenbezug wiederherstellen. Für euch als Verantwortliche mit dieser Zuordnungsmöglichkeit bleiben das personenbezogene Daten. Pseudonymisierung ist eine Schutzmaßnahme, kein Ausstieg aus der DSGVO. (Art. 4 Nr. 5 DSGVO)
Anonymisierung geht weiter: Die Person darf unter Berücksichtigung aller Mittel, die der Verantwortliche oder andere nach allgemeinem Ermessen wahrscheinlich einsetzen, nicht mehr identifizierbar sein. Dabei zählen unter anderem Aufwand, Kosten und verfügbare Technik. Es geht also nicht bloß darum, ob du eine Ersetzung rückgängig machen kannst. Auch ohne Zuordnungstabelle kann der verbliebene Inhalt die Person verraten. Wirklich anonyme Informationen fallen nicht unter die DSGVO; das Anonymisieren personenbezogener Ausgangsdaten selbst ist allerdings noch eine Verarbeitung. (Erwägungsgrund 26 DSGVO)
Gerade bei juristischen Sachverhalten steckt die Identität nicht nur im Namensfeld. Ein Beispiel: die einzige Chefärztin einer bestimmten Fachrichtung in einer Kleinstadt, dazu Klinik und genaues Kündigungsdatum. Den Namen kannst du schwärzen. Der Rest stellt sie trotzdem vor. „Namen entfernt“ ist deshalb weder ein Anonymisierungsnachweis noch automatisch eine sauber umgesetzte Pseudonymisierung.
Für Staging heißt das: Wenn ihr dort weiterhin personenbezogene Daten verarbeitet, braucht ihr auch dafür eine tragfähige Rechtsgrundlage, einen zulässigen Zweck, Datenminimierung, geregelte Zugriffe, Löschfristen und risikogerechte Sicherheitsmaßnahmen. Staging wird dadurch nicht rechtlich identisch mit Prod. Aber die DSGVO kennt keine Ausnahme namens „Ist doch nur Test“. (Art. 5, 6 und 32 DSGVO)
Für Infrastruktur-Smoke-Tests nehme ich deshalb vorzugsweise frei konstruierte synthetische Daten ohne Bezug zu realen Personen. Für fachliche Evals müssen die Testfälle zusätzlich die relevanten Fehler und Grenzfälle abdecken. Und wer synthetische Daten aus echten Mandatsdaten generiert, muss prüfen, ob reale Inhalte oder identifizierende Merkmale übernommen werden. „Synthetisch“ ist kein Weihwasser. Der Jurist in mir verlangt hier keinen identischen Prod-Aufbau, sondern einen belastbaren Nachweis, welche Daten verarbeitet werden und warum das vertretbar ist.
8. DEIN MODELL HAT EIN VERFALLSDATUM, UND AZURE TAUSCHT ES DIR UNGEFRAGT AUS
Für eine klassische Web-App reicht CI/CD. Bei einer LLM-Plattform musst du zusätzlich damit rechnen, dass sich das Modell unter dir verändert, ganz magisch, ohne Code-Change.
UPGRADE POLICY
Ein Azure-OpenAI-Deployment hat dafür eine Upgrade Policy. In der Voreinstellung wird sinngemäß automatisch umgestellt, sobald Microsoft eine neue Default-Version setzt. Ohne festen Termin, ohne Change-Fenster; ausgelöst allein durch den Moment, in dem der Provider die neue Version zur Default erklärt. Wer diese Policy nicht bewusst auf „Upgrade when expired“ oder „No auto upgrade“ setzt, bekommt irgendwann ein anderes Modell unter demselben Deployment-Namen. Der Code ist unverändert, die Tests waren grün — die Antworten sind es möglicherweise nicht mehr.
Warum das als Modelldrift sichtbar wird: Streng genommen driftet hier nicht ein unverändertes Modell „langsam weg“. Der Provider tauscht die Modellversion aus. Damit können sich Gewichte, Trainingsstand, Alignment und internes Antwortverhalten ändern, während Deployment-Name, API und Anwendungscode gleich bleiben. Für dieselben Prompts entsteht eine andere Verteilung möglicher Antworten: Klassifikationen kippen, Tool Calls werden anders gewählt, strukturierte Ausgaben brechen oder Sicherheitsfilter reagieren plötzlich strenger.
Aus Betriebssicht ist das Behavioral Drift durch einen verdeckten Modellversionswechsel: Die in Tests gemessene Baseline passt nicht mehr zu dem Modell, das gerade in Produktion antwortet.
Und die grünen Tests? Sie belegen nur, dass die alte Modellversion sie bestanden hat. Wenn Golden Set und Regressionstests nach dem Upgrade nicht erneut gegen die neue Version laufen, sind die grünen Häkchen historische Dekoration.
Der Endpunkt heißt noch gleich. Der Spieler im Trikot ist ein anderer.
PINNEN HILFT AUCH NICHT
Pinnen ist keine Dauerlösung, sondern ein Termin. GPT-4o (u. a. 2024-05-13 und 2024-08-06) wurde zum 31. März 2026 retirert, mit Auto-Upgrade auf ein Nachfolgemodell. Microsoft kommuniziert Retirement-Daten für GA-Modelle inzwischen oft schon beim Launch, oft etwa 18 Monate im Voraus. Wer pinnt, kauft sich Stabilität heute gegen eine Migration mit Deadline morgen. Und die Ankündigung landet bei Owner/Contributor/Reader der Subscription; also gern in einem Postfach, das niemand operational überwacht.
Warum das kein Kosmetikproblem ist: Apple-Forscher nennen die hässliche Variante „negative flips“; Fälle, die das alte Modell korrekt gelöst hat und das neue falsch löst, obwohl die Gesamtqualität steigt. Der Durchschnitt kaschiert genau die Regressionen, an denen dein Workflow hängt.
Aus der Praxis kommt dazu ein wiederkehrendes Muster: Ein stilles Provider-Update kann monatelang aufgebaute LLM-as-Judge-Scores entwerten, weil der „Richter“ plötzlich nach einem anderen Maßstab urteilt.
LÖSUNGSVORSCHLAG
Was daraus folgt ⇒ in der Reihenfolge, in der ich es baue:
- Deployment-Version im IaC explizit setzen, Upgrade-Policy explizit konfigurieren, Retirement-Datum als Wiedervorlage ins Board. Kein „latest“, kein Alias.
- Prompts im Repo versionieren, nicht in irgendeinem Playground. Ein Modellwechsel ohne Prompt-Version ist ein Experiment ohne Kontrollgruppe.
- Evals in Test/Staging mit Golden Set, Groundedness-Checks und Regressionstests. Und: Der Judge wird genauso gepinnt wie der Kandidat — sonst ist bei einem roten Lauf unklar, wer sich bewegt hat.
- Jeder Modellwechsel läuft durch dieselbe Strecke wie eine Datenbankmigration: Eval, Shadow-Traffic, Canary, definierter Rollback-Pfad.
- Traces pro Anfrage inklusive Prompt- und Modellversion. Das brauchst du ohnehin für Nachvollziehbarkeit ⇒ aber das ist ein anderer Artikel.
9. MICROSOFT-HOSTED AGENTS KOMMEN NICHT DURCH DEINEN PRIVATE ENDPOINT
Wenn die Plattform komplett privat hängt (und bei Mandantendaten sollte sie das), dann erreicht die Standard-Pipeline deine Ressourcen nicht. Self-hosted Agents oder Managed DevOps Pools im VNet sind Woche zwei, nicht Woche acht. Wer das spät entdeckt, „löst" es mit einer temporären öffentlichen Freigabe, und temporär ist in der IT bekanntlich das Wort für ewig.
10 (BONUS CHAMBER). ROLLBACK IST DESIGN, KEIN NOTFALLPLAN
Rollback ist kein Wiki-Artikel, sondern eine ausführbare Aktion. Wenn du ihn nur als Runbook dokumentierst, besitzt du in Wahrheit keinen Rollback. Du besitzt Text. Ein Rollback muss als Befehl funktionieren, den jemand um drei Uhr nachts ohne Nachdenken ausführt. In Azure Container Apps ist das machbar, aber nur, wenn du drei Entscheidungen vorab triffst:
- Multiple-Revision-Mode statt Single. Standard ist Single: neue Revision rein, alte weg => „Rollback“ heißt dann Redeploy. Im Multiple-Mode bleiben mehrere Revisionen parallel aktiv. Du steuerst den Traffic per Gewichtung, und der Rollback ist ein
ingress traffic setzurück auf 100 % der vorherigen Revision. Sekunden statt Build-Pipeline. - Deterministische Revisionsnamen. Nutze einen stabilen Revision-Suffix (Commit-Hash oder Build-Nummer) und ergänze Labels wie blue/green. Sonst rollst du nachts auf „die vorletzte, glaube ich“ zurück und das ist kein Rollback, sondern Glücksspiel.
- Ein Build, Promotion per Digest. Das Image wird einmal gebaut und anschließend per Digest durch Dev, Test und Prod promotet. Kein Rebuild für Prod. Was in Prod läuft, muss byteidentisch zu dem sein, was in Staging freigegeben wurde. Sonst bedeutet „Rollback“: zurück zu etwas, das nie getestet wurde.
Der Ablauf, der sich in der Praxis bewährt hat (und den Microsoft so dokumentiert): neue Revision mit 0 % Traffic ausrollen, über die Label-URL testen, dann Canary (z. B. 5 % für mindestens 30 Minuten mit Blick auf Fehlerraten und Latenz-Perzentile), anschließend 25 %, 50 %, 100 %. Erst danach die alte Revision deaktivieren.
Wichtig: ACA (Azure Container Apps) löst den schwierigsten Teil nicht für dich ⇒ die Datenbank. Wenn Revision N+1 ein Schema ändert und du auf Revision N zurückschaltest, muss N mit dem neuen Schema weiterlaufen. Das erzwingt expand/contract-Migrationen: erst additiv erweitern, Code auf alt+neu vorbereiten, alte Spalten erst ein bis zwei Releases später entfernen. Fachlich riskante Änderungen zusätzlich hinter Feature-Flags, damit du zur Not abschalten kannst, ohne zu deployen. Und: Den Rollback-Pfad in Staging mindestens einmal wirklich gehen. Ein Rollback, den niemand je ausgeführt hat, ist keine Fähigkeit. Es ist bestenfalls eine Hypothese.
SO BAUT MAN ES (DIE GRAFIK)
Das Diagramm unten zeigt die Bausteine als drei Schichten mit dem, was ich „Plattform-Contract" nenne: die explizite Grenze zwischen dem, was das Plattformteam liefert und besitzt, und dem, was das Projekt per IaC anlegt und verantwortet. Die drei Prüfungen aus Punkt 2 sind als Gates eingezeichnet.
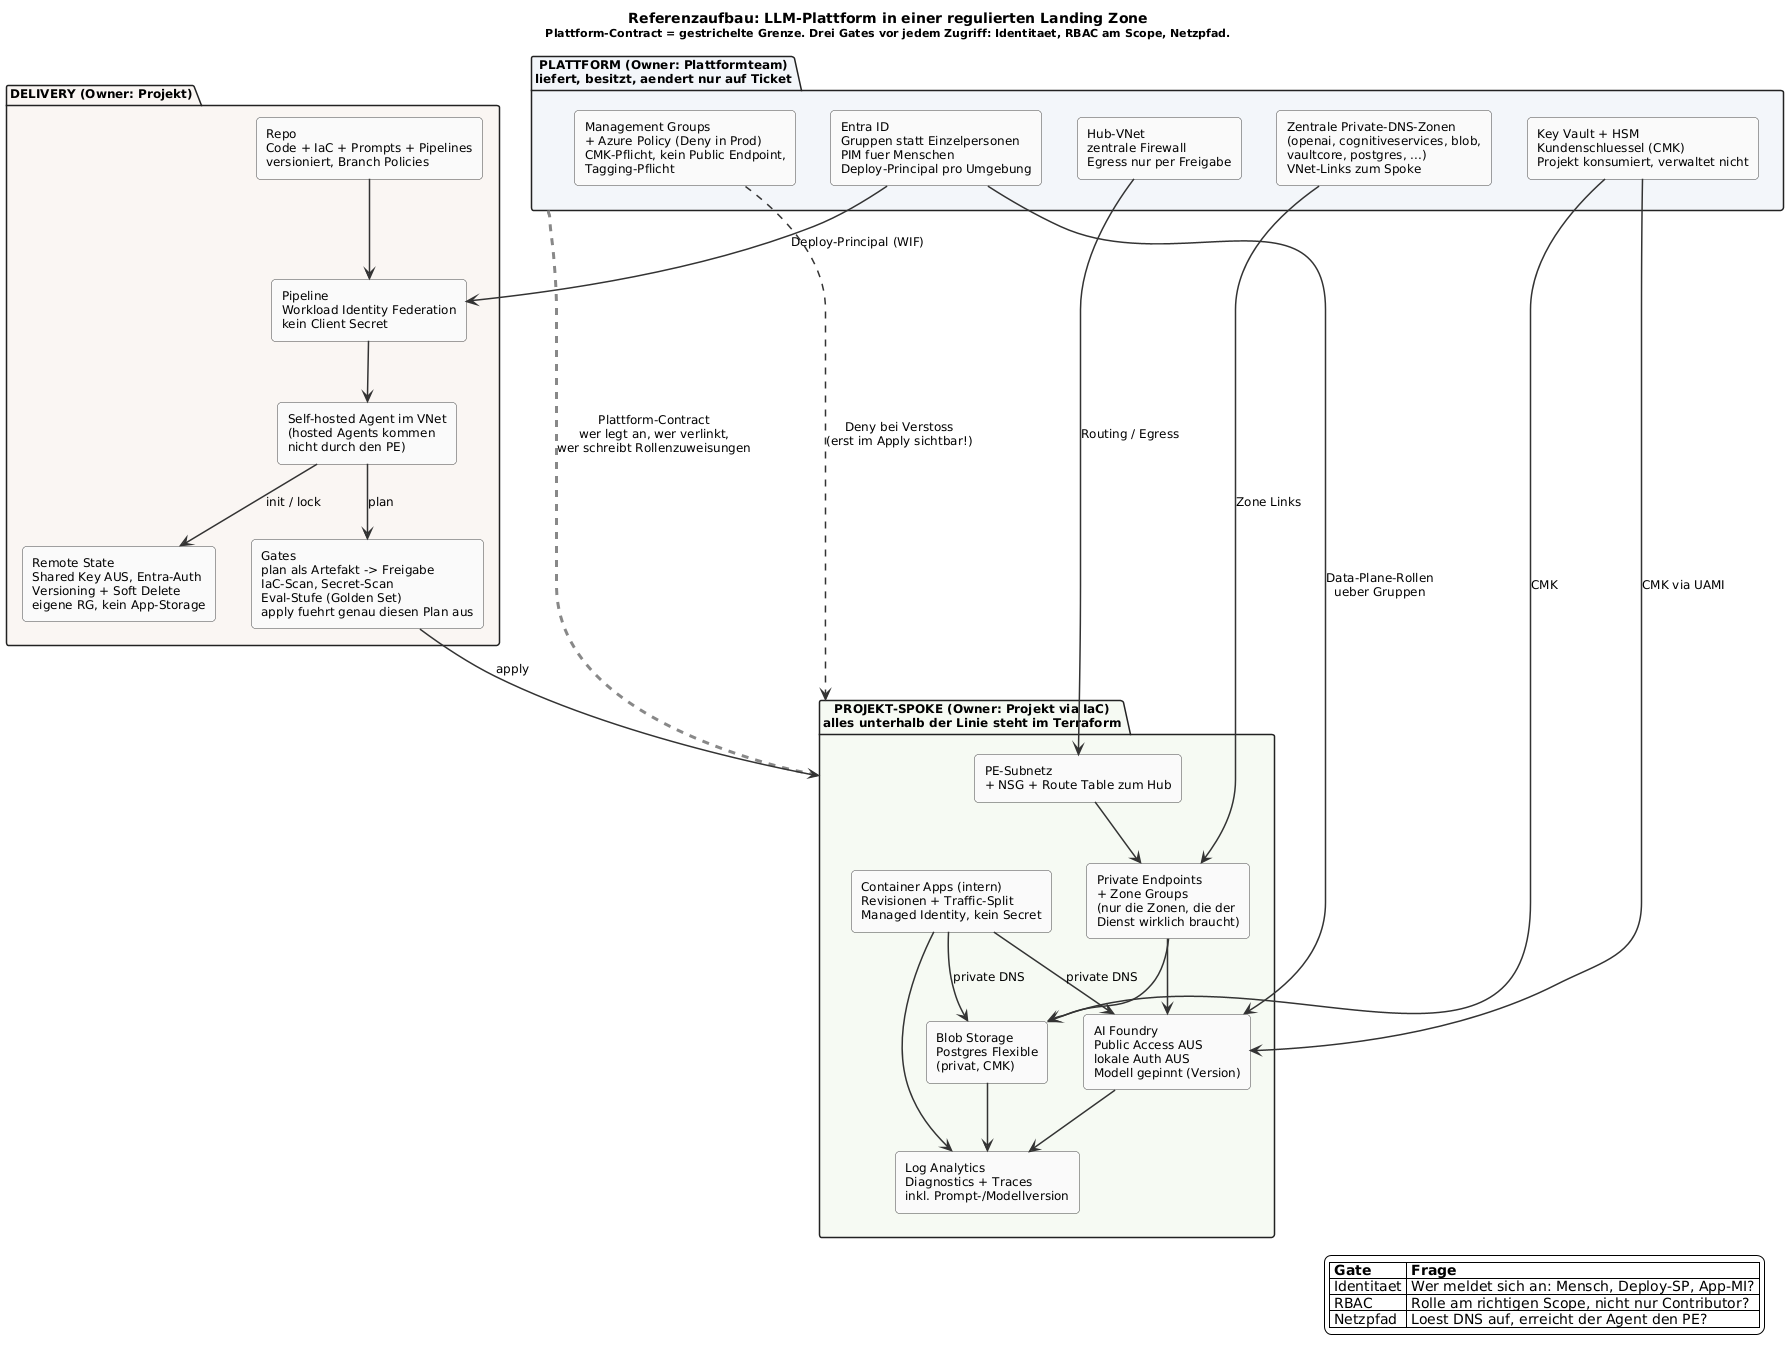
(c) Gerendert von Claude auf Basis eines PUML-Diagramms
Der Punkt, der in keinem Vendor-Diagramm steht: Die gestrichelte Linie ist der wichtigste Teil. Ohne sie weiß niemand, wer das Subnetz anlegt, wer die DNS-Zone verlinkt und wer die Rollenzuweisung schreibt. Und dann steht das Modell, und keiner kommt dran.
VERSTECKTER CTA
In eigener Sache: Wenn eure KI-Plattform mehr können muss als eine hübsche Demo: Ich verbinde technische Führung, Azure-Architektur und KI-Compliance: vom ersten Terraform-Plan bis zum belastbaren Betrieb.
Sprecht mit mir. Ich bin zurzeit verfügbar.
Quellen und weiterführende Links
- Podcast (ich habe ihn auf Apple Podcast gehört): Die Cloud Optimizer, S2F14 „Terraform in Azure, bevor der erste terraform apply läuft" (Matthias Braun, Christian Forjahn), Show Notes auf Substack
- Microsoft Learn: Azure OpenAI Model Retirements and Deprecations; Blue-Green Deployment in Azure Container Apps; Traffic Splitting in Azure Container Apps
- Microsoft Q&A, Threads zu Auto-Upgrade-Policy und GPT-4o-Retirement (Frühjahr 2026)
- Matthias Braun, „Terraform AzureRM 5.0 Upgrade" (Preflight Validation im Plan)
- TianPan.co, „The Semver Lie" und „LLM-as-Judge Drift" (2026), zur Alias-Falle und zu Evaluator-Drift
- arXiv 2601.22025, „Evaluation-Driven Iteration for LLM Applications", Abschnitt zu stillen Regressionen nach Modell-Updates
- OneUptime Engineering Blog, Canary-Ablauf mit ACA-Revisionen (Februar 2026)