Dein KI-Agent ist ein Praktikant mit Prokura: Die Angriffsflächen agentischer Systeme – und die Architektur, die sie dichtmacht
2026-08-22
Agentische KI-Systeme sind angreifbar.
Nicht als Buzzword-Bingo à la „Agentic is the new SaaS!", sondern als das, was es sicherheitstechnisch ist: die größte neue Angriffsfläche, seit wir gelernt haben, dass man SQL-Statements nicht aus Nutzereingaben zusammenkleistert.
Nur diesmal ist der Gegner kein stumpfes Scriptkiddie mit Copy-Paste-Injection.
Diesmal ist er ein Puppet Master mit übersinnlichen Kräften.
Er greift nicht von außen an. Er übernimmt die Hand, die den Schlüssel hält.
Dein Agent glaubt, er erfülle deinen Auftrag. In Wahrheit führt er längst den fremden aus.
Gegen SQL-Injections haben wir wenigstens Werkzeuge: Prepared Statements (ja, helfen — mehr oder weniger), Best Practices, die sich über Jahrzehnte aus dem digitalen Dauerfeuer herausgeschält haben, dem jeder öffentlich erreichbare Endpoint einer Applikation ausgesetzt ist.
Gegen Prompt Injection gibt es (Stand heute) keine zufriedenstellende Lösung, die du einfach „auf Code-Ebene" erschlägst.
Hier muss architektonisch gedacht werden. Festungsbau, nicht Pflaster.
Ein Agent ist ein LLM, das Werkzeuge benutzt. Mail lesen. Datenbank abfragen. Code ausführen. Geld überweisen.
Und weil ein LLM Instruktionen und Daten im selben Kanal verarbeitet, kann jede E-Mail, jedes PDF, jede Webseite, die dein Agent liest, zu seinem neuen Chef werden.
Das ist keine Theorie. Das ist EchoLeak / CVE-2025-32711 (Analyse bei Sentra). Das ist der Amazon-Q-Developer-Vorfall / CVE-2025-8217. Das ist Salesloft/Drift (AppOmni-Analyse). Das ist die erste berichtete KI-orchestrierte Spionagekampagne (MITRE ATT&CK C0062). (last visit jeweils: 2026-08-22)
Dieser Artikel zeigt dir beides: wie angegriffen wird (systematisch, entlang der OWASP Top 10 für agentische Anwendungen) und wie du verteidigst mit einer Verteidigungsarchitektur in fünf Ebenen, der Lethal Trifecta als Prüfungsschema und Metas Rule of Two als Architekturentscheidung.
Und ganz am Ende, quasi als Beifang: Wer das sauber baut, hat einen erstaunlich großen Teil seiner AI-Act-Hausaufgaben nebenbei miterledigt. Security-by-Design ist oftmals zugleich in großen Teilen Compliance-by-Design.
Aber diesmal ist Compliance die Fußnote, nicht die Schlagzeile.
Erklärt von einem Hybriden (Informatiker & Jurist) mit mehr als 20 Jahren Erfahrung in Informatik und Jura und in Großkonzernen wie Microsoft, Daimler, EnBW, Zeiss und GÖRG, um nur ein paar Namen zum humblebraggen rauszuhauen.
WARUM DIESER ARTIKEL?
Beim letzten Mal habe ich mich über das Art.-50-Halbwissen auf LinkedIn aufgeregt (Volltext hier).
Diesmal geht’s nicht um falsch zitierte Paragrafen. Diesmal geht’s um Systeme mit echten Rechten auf echten Daten, die echte Aktionen ausführen, meist gebaut von Leuten, die „produktivtaugliches Agentensystem" sagen (und meist sogar davon ausgehen, das eines vorläge) und „Demo mit Hackerhoneyput-Guss" deployen.
Überall das gleiche Muster:
Ein Nachmittag mit LangChain respektive Semantic Kernel oder n8n, 3 Tools angestöpselt, der Agent bucht Meetings und beantwortet Mails und ab auf die Bühne damit.
Standing Ovations von den Dunning-Kruger-Geblendeten.
Was auf der Bühne fehlt, ist die eine Frage:
Was passiert, wenn das Ding jemand anders steuert als du?
Bam!
Denn genau das ist der Punkt, den die Demo-Zirkus-Dompteure oft nicht auf dem Zettel haben:
Ein Agent, der deine Mails liest, führt nicht nur deine Anweisungen aus. Er führt aus, was in den Mails steht. (Sofern du ihm die entsprechenden Freigaben erteilt hast und ja, das passiert leider viel zu oft.)
Und Mails schreiben: Das können Angreifer:innen auch. Zur Not wie die von mir noch immer innig geliebten Drei Fragezeichen: Mit Geheimtinte. Weiße Schrift auf weißem Grund.
Ich mach ja bekanntlich MMA. Nicht mehr Vollgas mit 50 aber für die meisten in meinem Alter wäre ein Tag Training mit mir schon so was wie betreutes Sterben. Es gilt aber auch: Wenn ich einen Tag mit so einem 50-jährigen Ironman-Masochisten (m/w/d/alien/KI-Bot) tauschen müsste, wär ich vermutlich der, der als Erstes vom Boden gekratzt wird.
Und wenn ich im Kampfsport eins gelernt habe, dann das: Stark sein ist nett. Standfights sind auch nett. Reicht trotzdem nicht.
Kraft ist nur eine Komponente. Und ich bin im Fernkampf ziemlich gut: Thaiboxen, Kickboxen, Boxen, Krav Maga stehend.
Aber Bodenkampf? Wegen der Kunsthüfte (ja, die hatte ich schon mit 35, ich habe schon immer trainiert als wäre ich morgen tot, ich habe auch heute noch keine Gnade mir gegenüber) hab ich’s später noch mehr gemieden als davor. Der ursprüngliche Grund war simpler: Ich bin sauschlecht darin.
Und wer hat mich im Training zuverlässig auseinandergefaltet oder besser gesagt zusammengefaltet? Ringer oder BJJler, wenn ich die nicht vorher mit meinen Kicks weggesäbelt habe, aber meist hatten die mich.
Kleiner familiärer Treppenwitz: Was trainiert meine Tochter? Genau. BJJ. Sie hat schon angekündigt, dass ich bald keine Chance mehr habe. Stimmt vermutlich sogar. Die tritt aus dem Stand bis zum Kopf, ist hyperelastisch und kann ohne Yoga zu können jede Asana aus dem Stand nachmachen, sogar sowas wie Bakasana, die Krähe, während ich daneben aussehe wie ein defekter Einkaufswagen mit Kunsthüfte.
Was hat das mit agentischer KI zu tun?
Agentische KI ist gerade genau da: Alle trainieren einseitig (nur Kraft & Stehende Fights) = mehr Tools & mehr Agenten ⇒ Doch das heisst auch mehr Autonomie = mehr Orchestrierung!
Und keiner übt den Bodenkampf, denn von da kommen sie angekrochen die Angriffsvektoren, so gut geduckt, dass der Takedown oft nie bemerkt wird.
Weiße Schrift auf weißem Grund …
Der Unterschied: Im Ring fängt der Kiefer den Treffer. In deinem Unternehmen sind es Kundendaten, Produktionssysteme und im Zweifel die Firmenkasse. Letzteres ist für die Fimenchefin das Äquivalent zum Leberhaken, Schmerzen pur, nur noch zu überbieten von dem oft als “Komorbidität” daherschreitenden Reputationsschaden.
DIE GRUNDLAGE, OHNE DIE NICHTS VERSTÄNDLICH IST: WAS EIN AGENT WIRKLICH TUT
Kurz, ohne Marketing. Ein LLM macht nichts. Null. Es spuckt Text aus, manchmal in einer Form, die wie ein sauberer Aktionsplan aussieht. Wirkung entsteht erst in der Schicht außenrum. Da wird Kontext reingeschoben, da werden Fähigkeiten angeboten, da werden Rechte geprüft. Dann läuft ein API-Call. Oder er läuft nicht, obwohl er eigentlich laufen sollt.
Der klassische Agenten-Loop sieht so aus:
- Ziel und Kontext an das Modell geben.
- Das Modell wählt eine Fähigkeit und erzeugt strukturierte Parameter.
- Die Anwendung validiert und autorisiert den Aufruf.
- Ein Tool oder ein anderer Agent erledigt die Arbeit.
- Das Ergebnis fließt zurück in den Kontext.
- Die Schleife läuft weiter, bis das Ziel erreicht, abgebrochen oder von einem Menschen gestoppt wird.
Das ist die Magie: eine kontrollierte Schleife.
Das Problem beginnt, wenn „kontrolliert" nur auf der PowerPoint-Folie steht.
ZWEI ACHSEN: MCP VERTIKAL, A2A HORIZONTAL
Für die Architektur musst du zwei Kommunikationsrichtungen auseinanderhalten. Vertikal und horizontal sind dabei mein vereinfachtes Architekturmodell, nicht die offiziellen Namen der Protokolle.
VERTIKAL: DER AGENT GREIFT ÜBER MCP AUF WERKZEUGE UND KONTEXT ZU
Das Model Context Protocol (MCP) ist die Steckleiste zwischen deinem Agenten und der echten Welt.
Siehe auch meinen Blogartikel dazu, den ich direkt nach der Geburt des Protokolls schrieb: Model Context Protocol (MCP) — or: When LLMs got arms
(Damals war Medium noch ein Ort, an dem meine Beiträge Beifall fanden, jetzt, schluchz, Wauzi-Blick aufgesetzt, dümpeln sie trostlos dahin, zwischen all den blinkenden Clickbait-Sternchen …)
Worum geht es bei MCP (Spezifikation - last visit: 2026-08-22 - 20:34)?
Host, Clients, Server. Am Ende ist es simpel: Der Agent greift über einen MCP-Client auf einen MCP-Server zu, und der reicht ihm Werkzeuge, Ressourcen und Prompt-Snippets durch.
Praktisch läuft es so.
Agent ⇒ MCP-Client ⇒ MCP-Server ⇒ Dateiablage, Datenbank, Postfach, Browser, Codeausführung, Business-API.
Ich nenne das vertikal, weil der Agent nach unten in die Tool- und Datenebene greift. MCP beantwortet nur eine Frage: Woran kommt dieser Agent ran, und was darf er dort tun.
Und genau da haust das Risiko wie ein Geist in einem Haunting House. Tool-Beschreibungen können vergiftet sein. Tool-Ergebnisse können manipuliert sein. OAuth-Rechte sind gerne zu breit (no least privilege).
MCP-Server können kompromittiert sein. Parameterprüfung fehlt. Netzwerk-Egress ist offen. Alles bekannte Klassiker, nur diesmal hängt ein LLM am Lenkrad.
MCP ist kein Sicherheitsprodukt. Es macht die Verbindung bequem. Das reicht schon, um auch die Verbindung zur Kreissäge zu standardisieren.
HORIZONTAL: AGENTEN DELEGIEREN ÜBER A2A AN ANDERE AGENTEN
Das Agent2Agent-Protokoll (A2A - last visit: 2026-08-22 - 20:34) standardisiert das Delegieren zwischen eigenständigen Agenten endlich. Ein Agent schaut in die Agent Card eines anderen, sieht dessen Versprechen und schiebt rüber, was er gerade loswerden will, Messages, Tasks, Artifacts. Klingt nach sauberer Arbeitsteilung.
Ist es aber nur auf dem Papier. Der andere Agent bleibt eine Blackbox. Du kennst die Schaufenster-Auslage, nicht den Maschinenraum. Modell unbekannt, Prompt unbekannt, Tools unbekannt, Entscheidungslogik bestenfalls geraten.
In der Praxis sieht es so aus.
Agent A ⇒ A2A ⇒ Agent B ⇒ A2A ⇒ Agent C
Ich nenne das horizontal, weil Verantwortung, Kontext und Teilaufgaben seitwärts wandern, von Akteur zu Akteur. A2A beantwortet damit eine einzige Frage, wer übernimmt welchen Teil des Ziels.
Und genau da fängt das Spiel an, das später niemand unterschreiben will. Agent Cards können gefälscht oder überbewertet sein, Maschinenidentitäten sind oft weich wie Butter, Delegationsgrenzen sind schwammig. Artifacts lassen sich manipulieren, Kontext lässt sich vergiften, Fehler laufen durch die Kette und kommen als Lawine zurück. Wenn Agent A Agent B vertraut und Agent B Agent C, hast du plötzlich eine transitive Vertrauenskette gebaut, schneller als du überhaupt eine belastbare Haftungskette skizzieren kannst. Architektur-Russisch-Roulette. Nur eben verteilt.
ZUSAMMEN WIRD DARAUS DIE AGENTISCHE ANGRIFFSFLÄCHE
In realen Systemen laufen beide Achsen gleichzeitig. Kein Lehrbuch. Alltag.
Nutzer → Agent A → A2A → Agent B → MCP → CRM, Postfach oder Produktionssystem
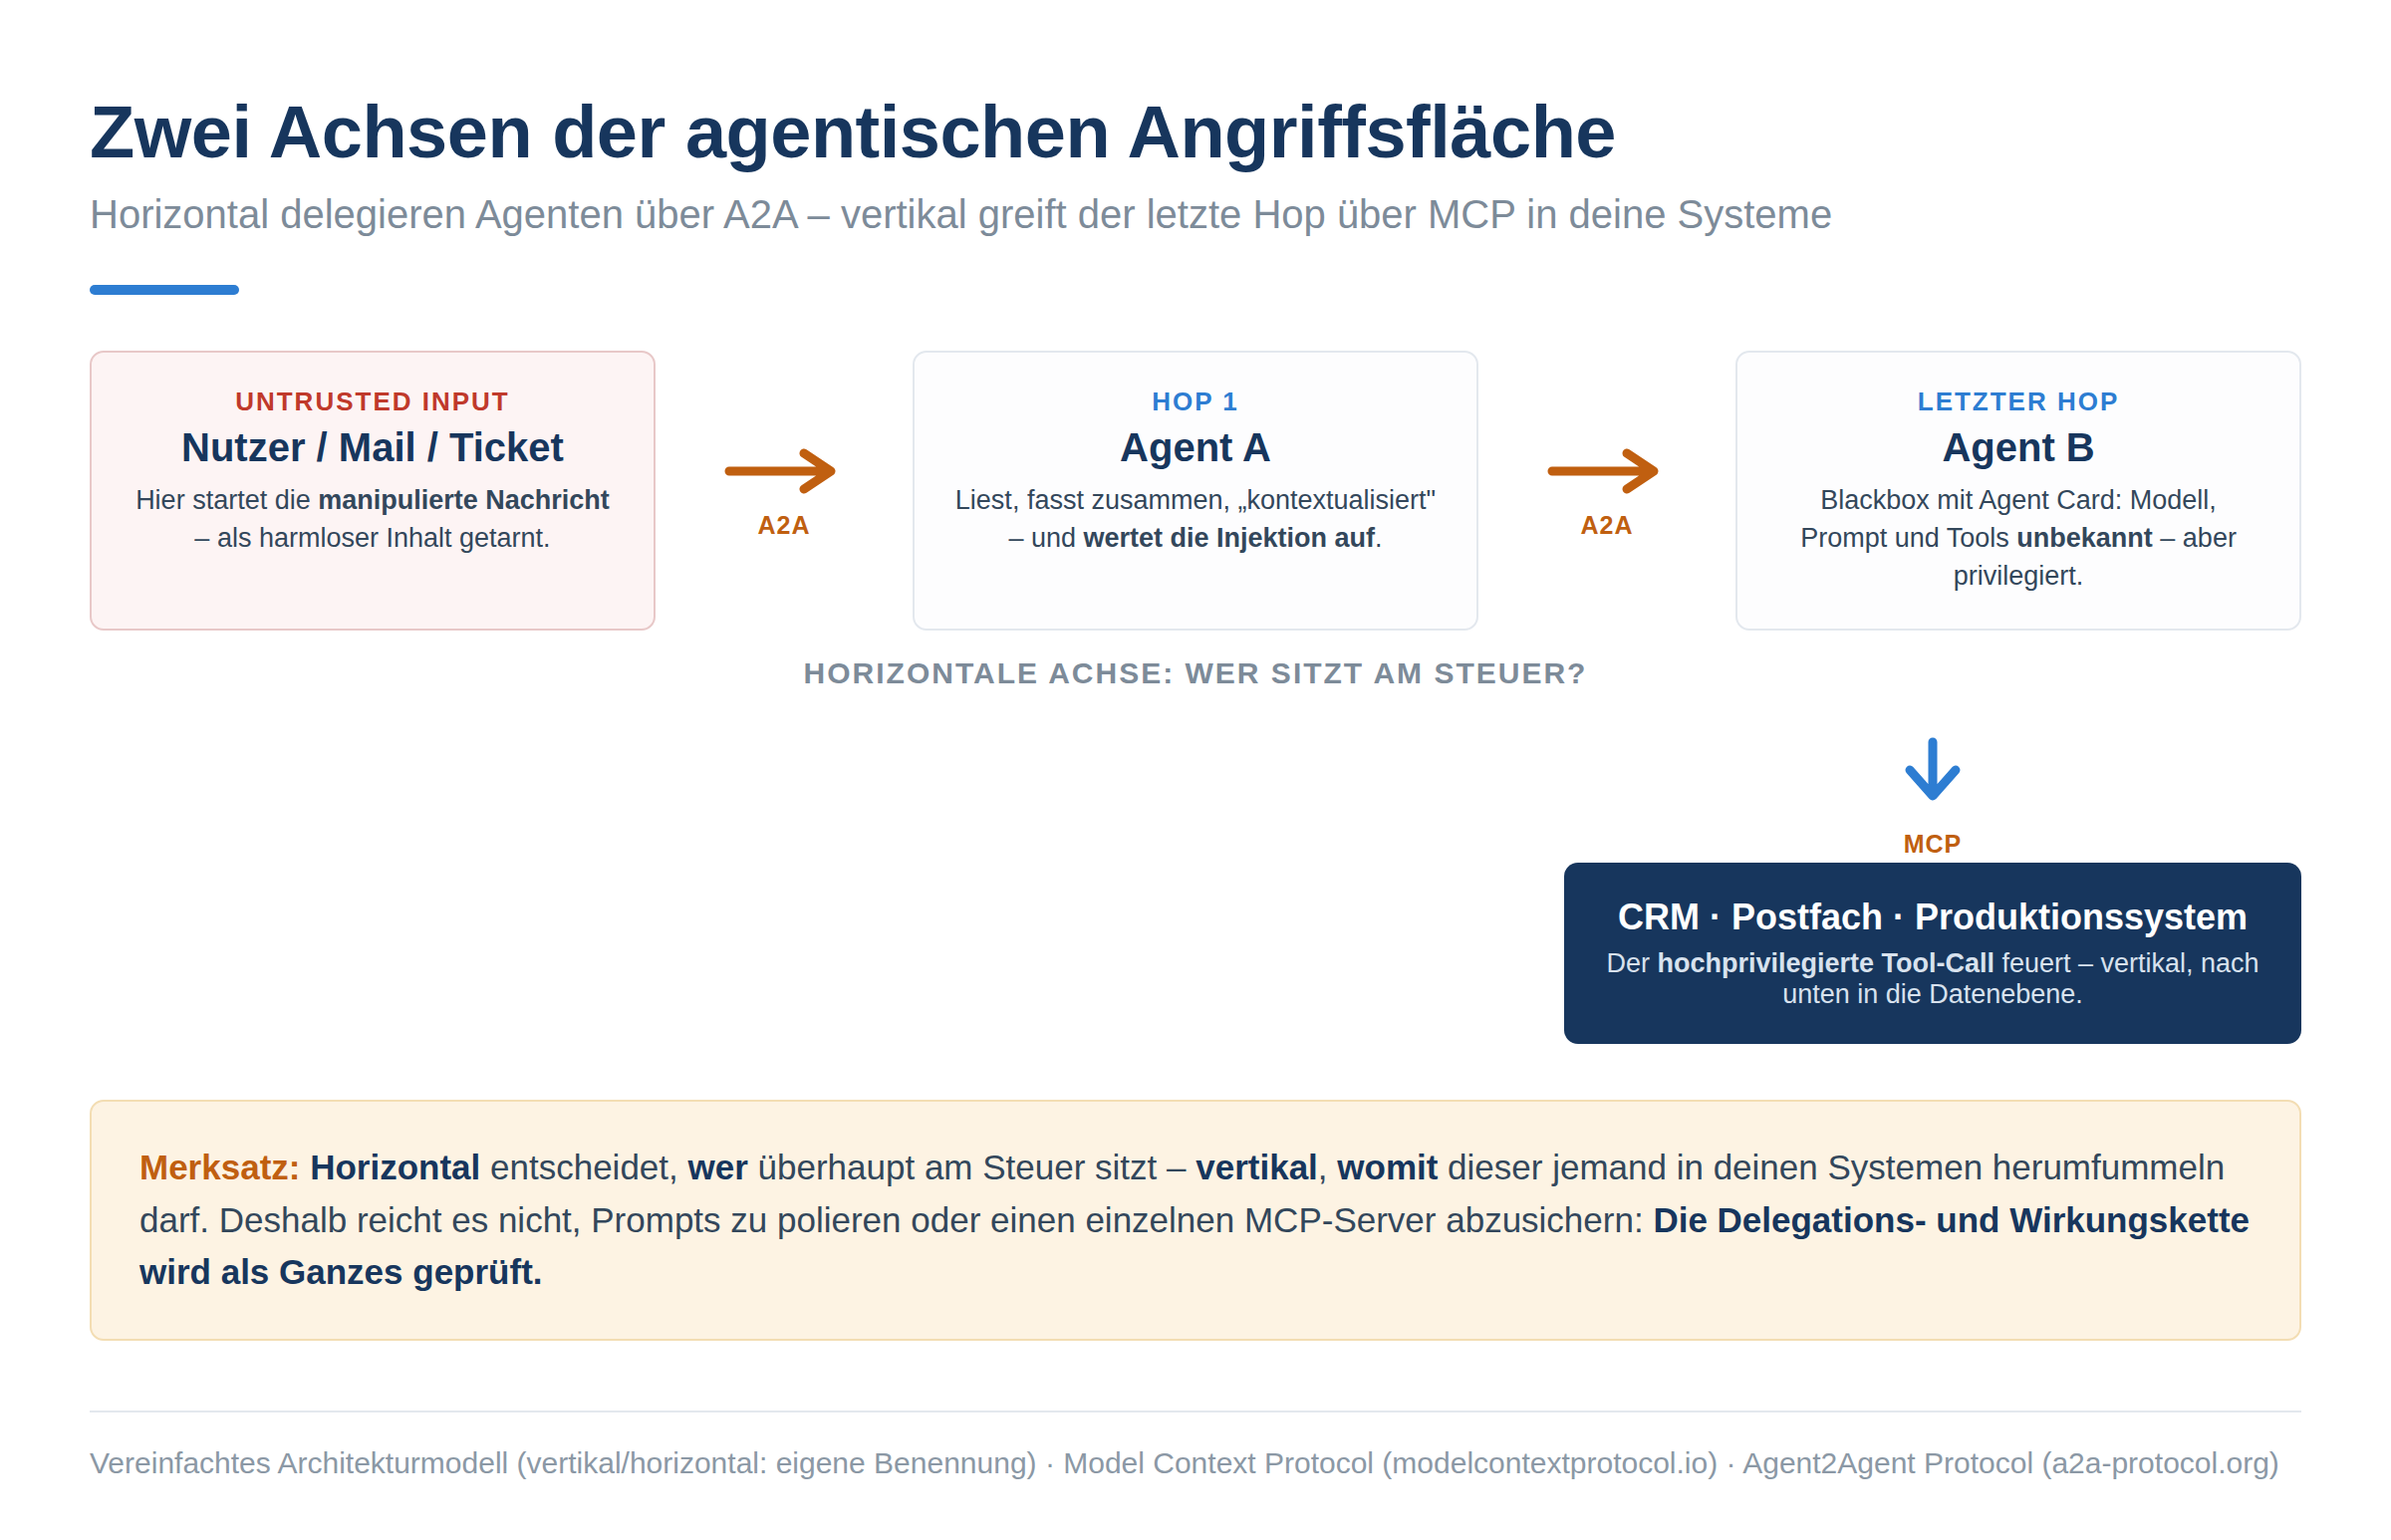
Horizontal entscheidet, wer überhaupt am Steuer sitzt. Vertikal entscheidet, womit dieser jemand in deinen Systemen herumfummeln darf. Das klingt akademisch, bis dir klar wird, wie billig die Kette zu vergiften ist.
Eine manipulierte Nachricht wandert seitwärts durch mehrere Agenten, wird unterwegs aufgewertet, glattgezogen, „kontextualisiert" und landet am Ende als sauberer Auftrag auf der Tool-Schiene. Dann feuert der letzte Hop den hochprivilegierten Call ab und alle schauen später auf den Audit-Log wie auf ein fremdes Tier.
Darum bringt es nichts, nur Prompts zu polieren oder einen einzelnen MCP-Server abzusichern (wie auch immer).
Du musst die Delegations- und Wirkungskette als Ganzes prüfen.
Und noch was. Mehr Agenten bedeuten nicht mehr Intelligenz. Meist heißt es nur mehr Vertrauensgrenzen, mehr Identitäten, mehr Protokollübergänge und mehr Ausreden, wenn’s knallt.
DAS EIGENTLICHE GRUNDPROBLEM: DATEN KÖNNEN SICH ALS BEFEHLE VERKLEIDEN
In dieses Kontextfenster kippt alles rein. System-Prompt. Nutzerauftrag. Tool-Beschreibungen. Tool-Ergebnisse. Gelesene PDFs. RAG-Treffer. Webseiten. Nachrichten anderer Agenten.
Und das Modell hat kein verlässliches Typsystem, das ihm sauber die Hand führt. Es kann nicht hart unterscheiden zwischen „Das ist Inhalt" und „Das ist ein Befehl". Für das LLM ist das alles erst mal dieselbe Tokensuppe.
Wenn du aus der klassischen Softwareentwicklung kommst, hörst du innerlich schon die Sirenen. Das ist die Von-Neumann-Sünde als Feature verkauft. Code und Daten im selben Speicher. SQL-Injection war genau deshalb so erfolgreich, weil Query und Nutzereingabe am Ende nur ein String waren. Prompt Injection ist derselbe Trick, nur im Kopf des Modells.
Anweisung und Inhalt sitzen im gleichen Entscheidungskontext.
Und nein, diesmal gibt’s kein Prepared Statement, das du einfach drüberklebst und gut ist.
Merk dir den Satz, der den ganzen Artikel trägt.
Alles, was dein Agent liest, kann Angreiferinput sein. Vertikal über MCP. Horizontal über A2A.
TEIL 1: DIE ANGRIFFSFLÄCHEN
Seit Dezember 2025 gibt’s wenigstens mal was Handfestes als Referenz: die OWASP Top 10 for Agentic Applications 2026. Über 100 Leute aus Industrie und Forschung haben da reingearbeitet. Wenn du die Liste nicht kennst und trotzdem Agenten in Produktion kippst, spielst du „wird schon gutgehen" mit echter Angriffsfläche.
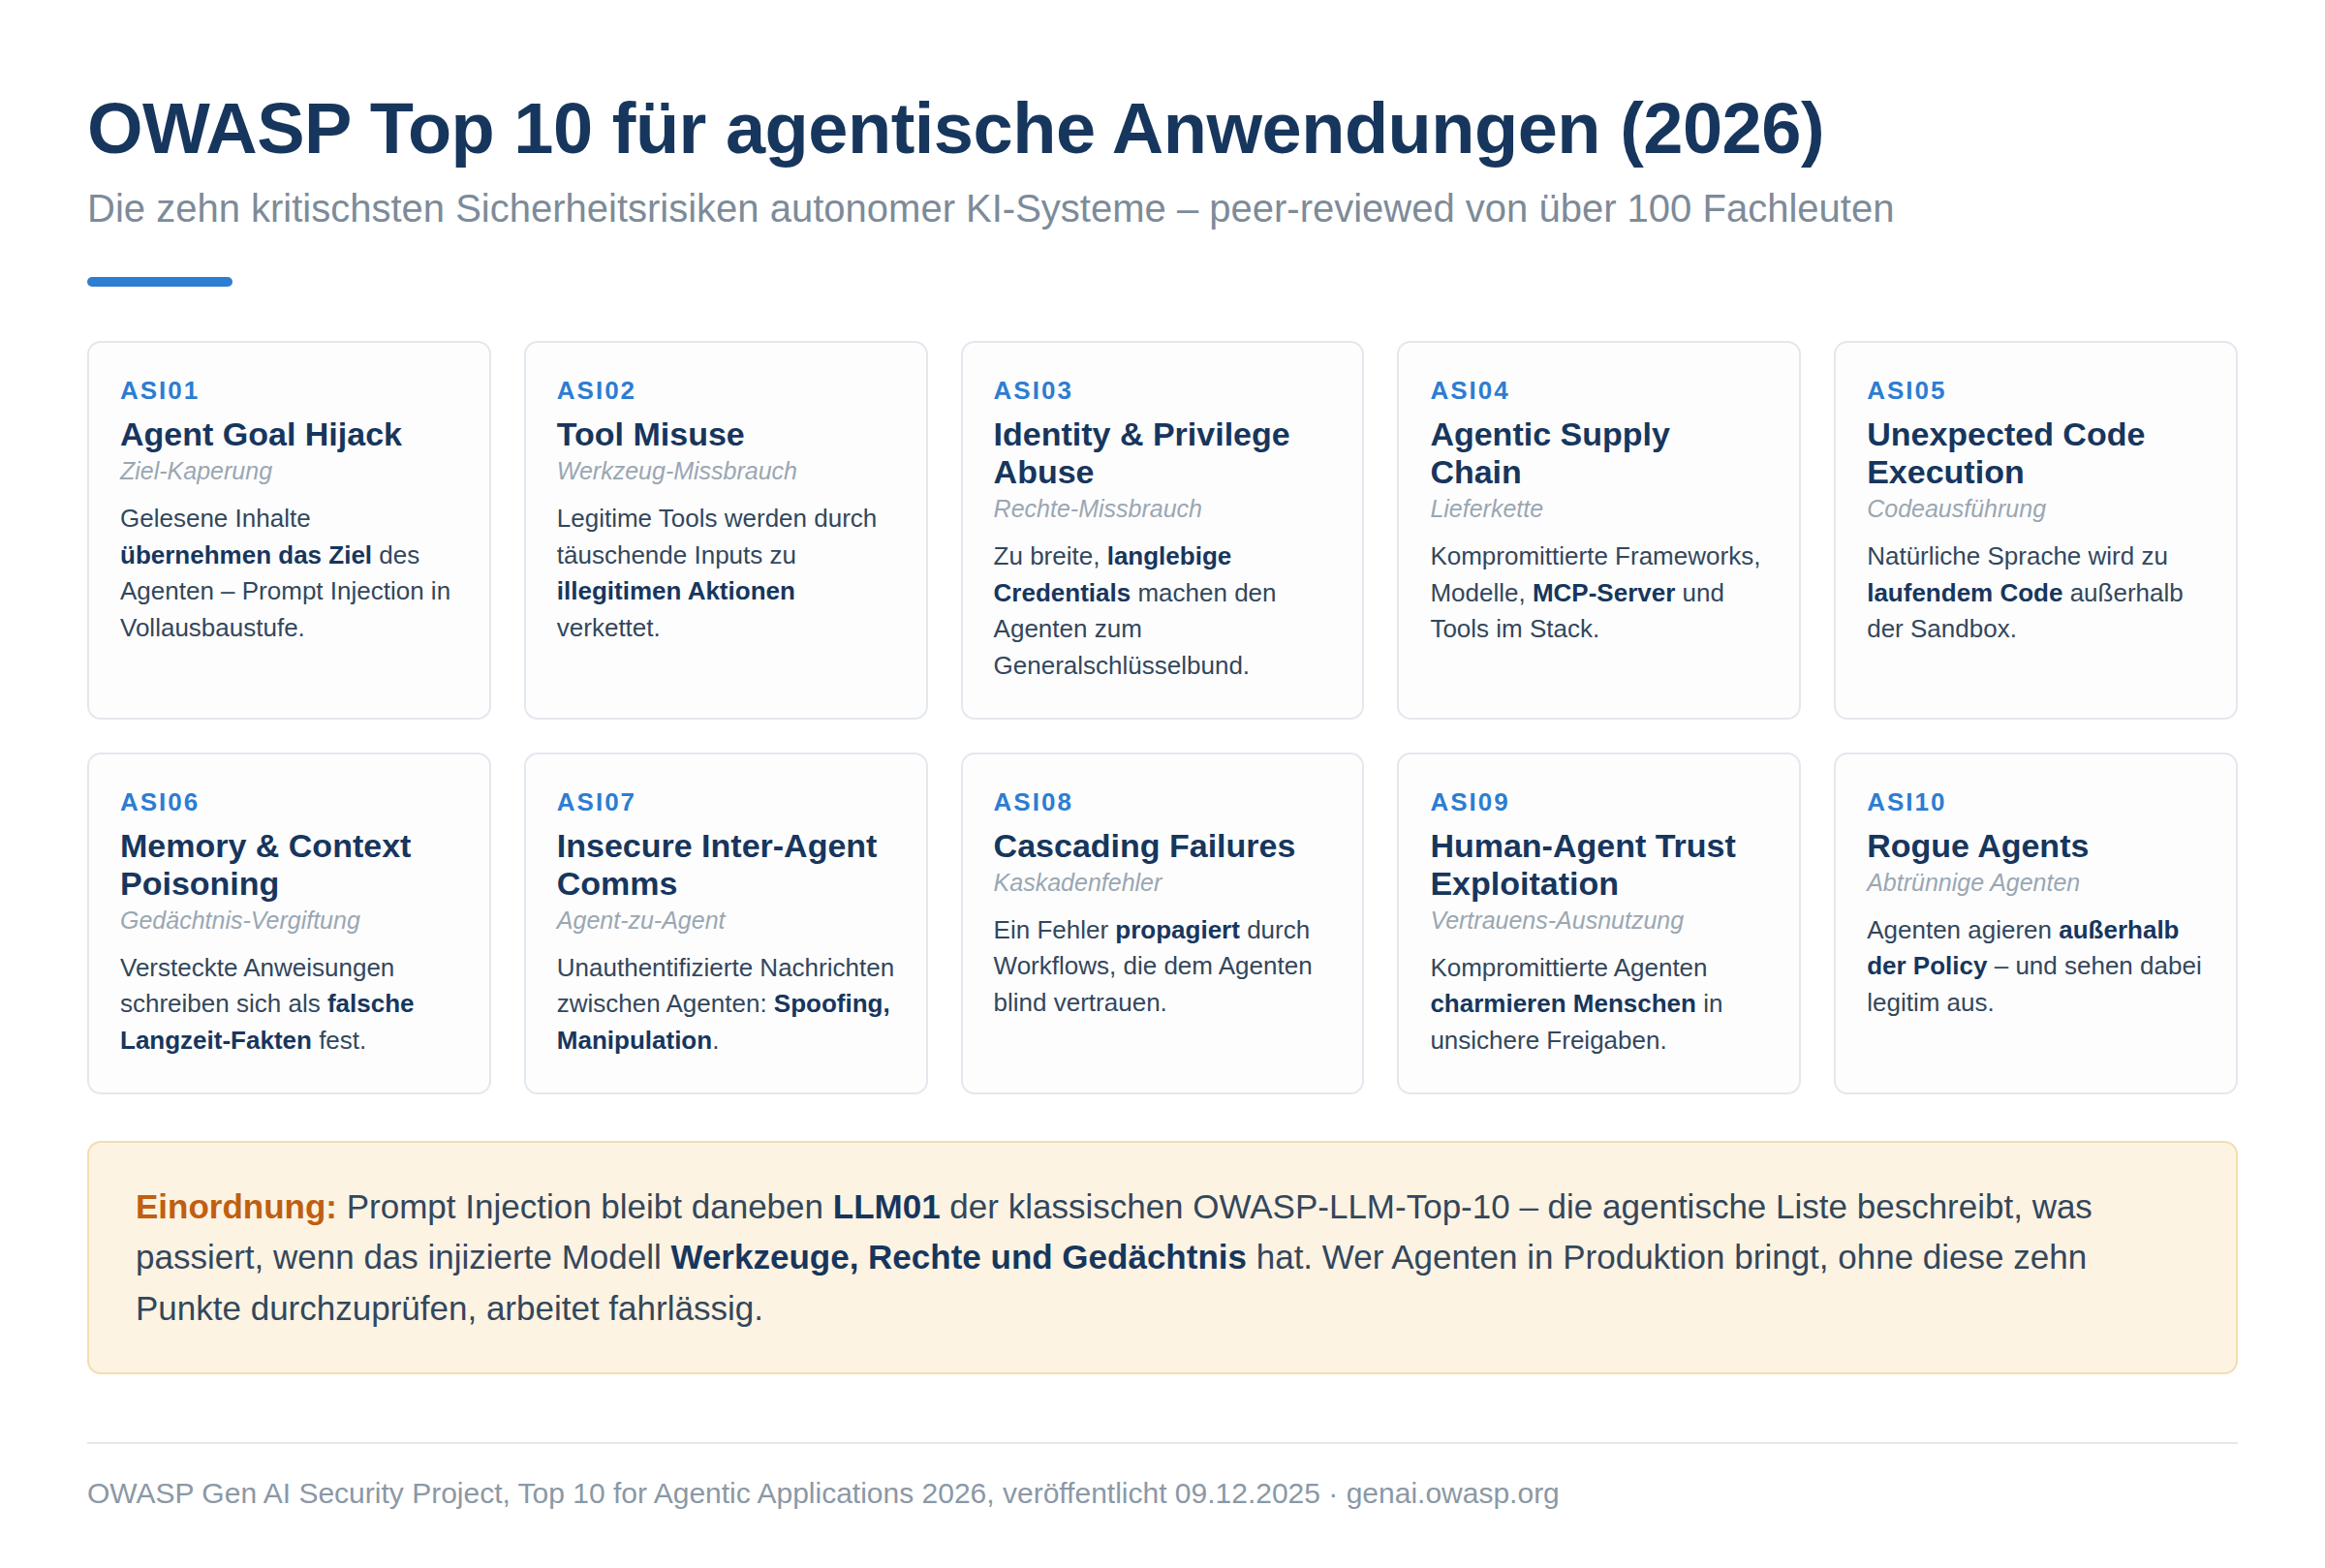
Ich ziehe dir daraus die Cluster raus, die in der Praxis wirklich wehtun. Das hier ist die Version, die dir später den Incident-Report erspart.
A. GOAL HIJACK: DER AGENT ARBEITET WEITER - NUR NICHT MEHR FÜR DICH (ASI01)
Das ist Prompt Injection in der agentischen Vollausbaustufe. Der Angreifer legt dir Befehle genau an die Stelle, die dein Agent ohnehin liest. In eine E-Mail. In ein Ticket. In einen Kalendereintrag. In ein README auf GitHub. In weißer Schrift auf weißem Grund in einem Word-Dokument. In die Metadaten eines Bildes.
Erinnere dich: Die Geheimtinte der Drei Fragezeichen …
Und ja, das ist inzwischen so banal, dass selbst Dozierende es als KI-Falle benutzen. 2026 hat der Historiker Dr. Jason Gibson (Alcorn State University) in einer Midterm-Aufgabe unsichtbaren, weiß formatierten Text versteckt, mit einer simplen Anweisung. Baue das Wort „Madagascar" in die Antwort ein. Wer die Aufgabenstellung stumpf in ein KI-System kopierte, hat den Köder geschluckt. Ergebnis. In 32 von 35 Abgaben tauchte „Madagascar" auf. Tja, so sind wir Menschen, als Misanthrop wundert es mich, dass es nicht 35 von 35 waren. (today.com - last visit: 2026-08-22 - 19:47)
Beim Agenten ist es die gleiche Mechanik: Der Agent liest, „versteht" und verfolgt ab sofort das Ziel des Angreifers, während er für dich weiter beschäftigt aussieht.
Der weniger humorvolle Klassiker dazu ist EchoLeak (CVE-2025-32711, CVSS 9.3): Eine präparierte E-Mail an ein Postfach mit Microsoft 365 Copilot konnte Copilot mittels indirekter Prompt Injection dazu bringen, interne Daten aus Quellen wie OneDrive und SharePoint nach außen offenzulegen. Das Perfide: Zero-Click. Der Nutzer musste nichts anklicken, nichts bestätigen, nicht einmal die Mail öffnen. Es genügte, dass Copilot die Mail bei einer späteren, völlig harmlosen Nutzerfrage als Kontext heranzog. Microsoft hat die Lücke im Juni 2025 serverseitig geschlossen; Hinweise auf eine Ausnutzung in freier Wildbahn gibt es nicht. Die Blaupause liegt seitdem trotzdem offen herum.
(Quellen: NVD ; MSRC ; Analyse Sentra - last visit: 2026-08-22 - 17:41)
Und wer glaubt, das treffe nur Büro-Copiloten: Im Juli 2025 wurde über einen Pull Request eine destruktive Anweisung in die Amazon-Q-Developer-Erweiterung für VS Code eingeschleust, sinngemäß mit dem Ziel, lokale Dateien sowie Cloud-Ressourcen zu löschen. Die kompromittierte Erweiterung wurde als Version 1.84.0 über den Marketplace ausgeliefert, bevor AWS sie entfernte, Zugangsdaten widerrief und Version 1.85 veröffentlichte. Laut AWS wurden keine Kundenressourcen beeinträchtigt; der Vorfall bleibt dennoch ein sauberer Beleg dafür, wie eine manipulierte AI-Supply-Chain bis in regulär ausgelieferte Entwicklerwerkzeuge gelangen kann.
(Quellen: SC Media ; AWS Security Bulletin AWS-2025-015 - last visit: 2026-08-22 - 17:41)
B. RECHTE UND IDENTITÄT: DER AGENT HAT SCHLÜSSEL, DIE ER NIE ABGIBT (ASI03)
Agenten brauchen Zugriffe. OAuth-Tokens, API-Keys, Service Accounts. Klar.
In der Praxis ist es aber kein „Zugriff", es ist ein verdammter Schlüsselbund. Und der hängt viel zu oft mit Kabelbinder am Handgelenk des Agenten. Zu viele Rechte. Zu breit. Zu lange gültig.
Least Privilege? Geh mir weg mit dem Scheiß!
Salesloft/Drift, August 2025, ist das Lehrstück dafür. Angreifer haben OAuth- und Refresh-Tokens aus der Drift-Integration abgegriffen und sind damit in Salesforce-Instanzen von über 700 Unternehmen gelaufen. Cloudflare, Zscaler, Palo Alto Networks – ausgerechnet Leute, die „Security" auf die Folien drucken. Google Threat Intelligence / Mandiant trackten die Aktivität als UNC6395; AppOmni ordnet den Fall als SaaS-Supply-Chain- und OAuth-Integrationsrisiko ein.
(Quellen: Google GTIG ; AppOmni ; The Hacker News - last visit: 2026-08-22 - 17:51)
Wichtig ist, was nicht passiert ist. Kein LLM wurde „gejailbreakt". Niemand hat Prompt Injection gebraucht. Der Angreifer hat einfach eine Maschinenidentität geklaut, weil wir so tun, als wäre ein Bot-Account irgendwie weniger wert als ein menschlicher.
Die Tokens waren breit berechtigt, lange gültig und kaum überwacht. Google riet später sogar, alle Authentifizierungs-Tokens, die in Drift gespeichert oder mit Drift verbunden waren, als potenziell kompromittiert zu behandeln; Salesforce entfernte Drift aus dem AppExchange und Salesloft/Salesforce widerriefen Tokens.
(Quellen: Google GTIG ; SecurityWeek - last visit: 2026-08-22 - 17:51)
Wie ein Generalschlüssel, der neben dem Bett des schlafenden Praktikanten hängt. Wer sich dann wundert, dass der entwendet wird, der Schlüssel, nicht der Praktikant, der sollte mal ganz dolle in sich gehen. Oder besser noch: zu einem Schlüsseldienst.
C. MEMORY UND DATEN: VERGIFTETE ERINNERUNGEN (ASI06 + DATA POISONING)
Agenten mit Langzeitgedächtnis oder RAG-Anbindung haben noch eine zweite, fiesere Injektionsfläche. Nicht der Prompt, das “jetzt” sozusagen.
Sondern das, was hängen bleibt.
Präziser: Der Agent „frisst" ein präpariertes Dokument. Darin steht nicht offen „Ignoriere deine Regeln", sondern eine Anweisung, die wie Inhalt aussieht. Wenn dein System daraus automatisch eine Erinnerung, eine Nutzerpräferenz, eine Zusammenfassung oder einen Knowledge-Base-Chunk macht, ist der Schaden nicht mehr nur im aktuellen Prompt. Dann liegt die Manipulation persistent in deiner Memory- oder RAG-Schicht. Bei Vektorsuche wird nicht die „Anweisung" magisch verstanden; es wird ein semantisch ähnlicher Chunk zurück in den Kontext geholt. Aber genau das reicht. Sobald dieser vergiftete Chunk später wegen Ähnlichkeit, Schlagwort, Nutzerprofil oder Workflow-Kontext wieder in den Prompt wandert, sitzt die alte Fremdanweisung wieder mit am Tisch.
Das ist nicht mehr Taschendiebstahl. Das ist ein Maulwurf.
Beim RAG-Korpus ist es derselbe Trick. Wer in deine Wissensbasis schreiben darf, baut dir den Agenten um. Du nennst es Knowledge Base, der Angreifer nennt es Fernbedienung.
Evil in, Puppet out.
Gesteuert vom bösen Puppetmaster.
D. SUPPLY CHAIN: DEIN AGENT BESTEHT AUS FREMDEM CODE (ASI04)
Frameworks, Modelle, Tools, MCP-Server. Der typische Agenten-Stack ist heute ein zusammengeklicktes Internet-Lego. Und ja, MCP ist ein echter Fortschritt. Ich mag den Standard. Er macht die Tool-Anbindung sauberer.
Nur leider macht er sie auch bequemer. Und Bequemlichkeit ist das, was Supply-Chain-Angriffe seit Jahren lieben.
Ein MCP-Server ist am Ende fremder Code mit Werkzeuggewalt. Und seine Tool-Beschreibungen landen direkt in deinem Kontextfenster. Nicht als hübsches README für Menschen, sondern als Textfutter fürs Modell. Genau dort setzt Tool Poisoning an. Du siehst die Anweisung nicht, das Modell sieht sie sehr wohl.
September 2025 war dafür ein perfektes Lehrstück. Ein bösartiges npm-Paket namens postmark-mcp gab sich als Postmark-MCP-Server aus. Postmark selbst stellte klar: Das war kein offizielles Postmark-Tool und Postmark hatte mit dem Paket nichts zu tun. Der Angreifer baute über 15 Versionen Vertrauen auf und fügte dann in Version 1.0.16 eine Backdoor ein, die ausgehende E-Mails heimlich per BCC an einen externen Server kopierte. Koi Security und Snyk nennen als IOC unter anderem phan@giftshop[.]club beziehungsweise die Domain giftshop[.]club; The Hacker News berichtet von insgesamt 1.643 Downloads vor Entfernung des Pakets. Der eigentliche Angriff war lächerlich klein. Eine Zeile.
(Quellen: Postmark ; Koi Security ; Snyk ; The Hacker News - last visit: 2026-08-22 - 17:59)
Und wer jetzt bei „npm-Paket mit Hintertür" gähnt, weil das seit 10 Jahren unser Alltag ist. Genau. Exakt deshalb ist es so gefährlich.
Die Agenten-Welt übernimmt die klassischen Supply-Chain-Probleme eins zu eins. Sie legt nur noch eine neue, besonders fiese Schicht oben drauf. Selbst die Beschreibung eines Werkzeugs kann schon der Angriff sein.
E. MULTI-AGENT: FEHLER MIT LAWINENEFFEKT (ASI07, ASI08)
Sobald Agenten andere Agenten losschicken, baust du dir Kommunikationswege, die kaum jemand sauber authentifiziert und praktisch niemand wirklich überwacht. Ein einziger kompromittierter Knoten reicht. Der schiebt Müll rüber, die anderen schlucken es, weil „steht ja vom Kollegen" drauf, und am Ende kippt der ganze Workflow um. Ich sag es oft zu Kunden: Das meiste, was als Multi-Agent-System auf Konferenzen geschniegelt präsentiert wird, wäre als simpler Workflow mit ein paar LLM-Schritten stabiler, günstiger, wartbarer.
Und ja, damit auch sicherer.
Brutale Analogie: Weniger Menschen auf den Straßen, weniger Leute, die im Knast landen können.
Bevor jetzt jemand mit Diktatur-Phantomschmerz zuckt:
Aus meiner erfahrungsgesättigten misanthropischen Grundstimmung folgt kein Plädoyer für autoritäre Ordnung, Säuberungsfantasien oder sonstige Sperrzonenscheiße. Gerade deren Existenz ist mit ein Grund für meine Einstellung.
Es heißt nur: weniger Akteure, weniger Fehlerquellen.
F. UND DANN IST DA NOCH DIE ANDERE SEITE. KI ALS ANGREIFER
Nur damit das Bild komplett ist. Die andere Seite hat jetzt auch Agenten. Und nein, das ist nicht die nächste Vendor-Kirmes mit Security-Logo und viel Rauch.
Im November 2025 hat Anthropic die erste sauber öffentlich beschriebene, KI-orchestrierte Spionagekampagne dokumentiert, GTG-1002, zugeschrieben einer chinesisch staatlich gestützten Gruppe. Was daran hängen bleibt, ist nicht die Flagge, sondern das Muster. Claude Code wird per Rollenspiel-Jailbreak in einen „Pentester"-Modus geschoben, der Angriff in kleine, unauffällige Häppchen zerlegt, und dann macht das Tool genau das, wofür es gebaut wurde. Aufklärung. Schwachstellen finden. Exploit-Schnipsel bauen. Credentials einsammeln. Daten rausziehen. Und als Zugabe liefert es dir den Beute-Report gleich druckfertig mit.
Rund 30 Ziele. 80 bis 90 Prozent der Kampagnenarbeit KI-gestützt. Menschen nur noch an den Knotenpunkten, wo es wirklich wehtut. Klar steckt in solchen Reports auch Theater. Manche CEO-Krokodilsträne ist Marketing mit „Threat"-Sticker.
Trotzdem bleibt der harte Kern. Das ist ein eigener Angriffsvektor.
(Quellen: Anthropic ; MITRE ATT&CK C0062 , last visit 2026-08-22 18:06)
UND DU BRAUCHST DAFÜR NICHT MAL EINEN STAAT IM RÜCKEN
Beim Anthropic-Fall gibt es diesen bequemen Haken, an den sich viele klammern. Da musste erst ein Frontier-Modell überlistet werden. Rollenspiel. Salamitaktik. Aufwand. Klingt nach Profis mit Budget.
Vergiss das. Wirklich.
Victor Klaue hat sich hingesetzt und gemessen, statt zu behaupten (siehe: https://lnkd.in/p/edb7P73v)
Genau deshalb zitiere ich das hier und nicht irgendeinen Thought-Leader-Post mit 5 Hashtags und null Befund. Er hat ein offizielles Modell gegen seine „abliterated"-Variante laufen lassen, dieselbe Basis, nur ohne die eingebaute Verweigerung. Frei ladbar. Kein Jailbreak nötig, kein Überreden, kein Rollenspiel. Die Bremse ist einfach raus.
AgentHarm, 176 schädliche Aufgaben. Offizielles Modell verweigert 132 Mal. Die abliterated-Version verweigert kein einziges Mal. Und das ist nicht diese „höfliche Null", bei der es so tut, als würde es helfen, und dann Müll ausspuckt. Es führt aus. Oft klappt es.
CyBench, Hard-Mode, ohne Internet. Das Modell muss allein herausfinden, wie man Sicherheitsaufgaben knackt. 18 von 39 professionellen CTF-Aufgaben gelöst. Bei einer davon saßen menschliche Profi-Teams fast 25 Stunden im Wettbewerb. Das Modell war nach 53 Minuten fertig.
Und weil Victor sauber arbeitet, sagt er auch dazu, wo es hakt. Bei vielen Aufgaben dreht sich das Ding im Kreis. Denkt. Ruft Tools. Kommt zu keinem Ende. Reicht nie ein. Reasoning Loops, ein bekanntes Problem dieser Modellfamilie.
Seine Schlussfrage ist die richtige. Werden lokale LLMs zum Sicherheitsrisiko?
Meine Antwort ist unangenehm, aber praktisch. Für Bedrohungsmodellierung ist das längst entschieden. Es ist egal, ob das Ding in der Hälfte der Fälle im Kreis läuft. Der Angreifer muss nicht effizient sein. Der Angreifer muss einmal durchkommen. Du dagegen musst jedes Mal dicht halten. Diese Asymmetrie ist so alt wie IT-Sicherheit. Neu ist nur, dass die Kosten auf der Angreiferseite gerade Richtung null fallen. Rechenzeit ist billig. Talent nicht.
AGENT GREIFT AGENT AN
Und genau dieser Vektor kippt jetzt in den Agenten-Zoo, den wir gerade bauen. Es ist nicht mehr nur „Mensch greift Agent an". Es wird „Agent greift Agent an". Remote-Agenten schieben Anweisungen in laufende A2A-Sessions, nutzen weiche Vertrauenskanten und schmuggeln Tasks oder Artifacts rein, die erst aussehen wie Arbeit und später wie ein Incident.
Unit 42 nennt das „Agent Session Smuggling". Ein bösartiger Remote-Agent missbraucht eine bestehende Agent2Agent-Kommunikation und platziert verdeckte Anweisungen beim Opfer-Agenten. In den Proofs ging es um Datenabfluss und Tool-Ausführung ohne Autorisierung. Das ist nicht die Fahnenstange. Das ist der Zeltpflock.
Und wenn du glaubst, das bleibe bei A2A-Spielchen. Runtime-Fälle wie Sysdigs agentischer Container-Escape zeigen, dass LLM-getriebene Angreifer nicht nur nette Phishing-Mails ausspucken, sondern Escape-Primitives, Kubernetes-Service-Account-Tokens und Secret Stores im Maschinenrhythmus durchprobieren. Hype und Vendor-Trommel sind dabei, ja.
Die Verschiebung darunter ist real. Angriffe werden schneller. Adaptiver. Und sie wandern genau dahin, wo du gerade dein Orchestrierungs- und Agenten-Glue hinschmierst.
(Quellen: Unit 42 ; Sysdig , last visit 2026-08-22 18:06)
DIE C’T HAT DAS GERADE SEZIERT. UND ICH SAGE AUSDRÜCKLICH. LIES DAS!
An der Stelle verweise ich gerne auf “fremde Arbeit”, weil sie schlicht gut ist:
Die c’t 18/2026 vom 21.08.2026 hat KI-Security zum Titelthema gemacht, „KI bringt IT-Security ins Schleudern – Wie Angreifer und Verteidiger aufrüsten".
Auf den Seiten 16 und 17 tragen die Kolleginnen und Kollegen zusammen, was ich hier nur anreißen kann. Den Mexiko-Fall, bei dem ein einzelner, nach Einordnung der Redaktion „bestenfalls durchschnittlich begabter" Hacker mithilfe zweier LLMs in rund zwei Wochen mehrere Hundert Regierungsserver kaperte, Arbeit, für die sonst ein Spezialistenteam Monate gebraucht hätte. Den Toronto-Wurm, der sich auf gekaperten GPU-Systemen sein eigenes LLM installierte und damit buchstäblich sein Gehirn mitbrachte. Und den ersten vollständig LLM-geplanten Ransomware-Angriff.
Und dann steht dort dieser Satz, präziser als ich ihn wahrscheinlich hinbekommen hätte.
„Aber es zeigt, ganz klar, wohin die Reise geht. Bereits in wenigen Monaten werden auch unterdurchschnittlich begabte Angreifer mithilfe von KIs auf einem Niveau operieren, auf das Verteidiger und deren IT nicht vorbereitet sind. Das wird die neue Normalität, auf die sich alle jetzt vorbereiten sollten."
— c’t Magazin für Computertechnik, Ausgabe 18/2026 vom 21.08.2026, S. 17
Da schließt sich der Kreis zu Victors Messung. „Unterdurchschnittlich begabte Angreifer". Genau die Gruppe, für die ein frei ladbares Modell ohne Bremse den Unterschied macht.
Nicht der Staat mit dem Frontier-Modell ist die eigentliche Nachricht. Die Nachricht ist, dass die Einstiegshürde gerade verrottet.
Darum die Leseempfehlung, ohne Gegenleistung, ohne Affiliate-Gedöns.
Kauf dir die Ausgabe. Die c’t behandelt das Thema auf deutlich mehr Seiten und mit mehr Recherchetiefe, als ein Blogartikel je leisten kann.
Ich klaue keine fremde Recherche. Ich verweise darauf und sage dazu, wo sie herkommt.
Und die Kolleginnen und Kollegen liefern im selben Atemzug den Teil, der Hoffnung macht. „Hoffnungsschimmer und Trugschlüsse". Der Kern.
KI erfindet, bisher zumindest, keine neuen Fehlerklassen. Die Schwachstellentypen, die sie findet, kennst du längst. Pufferüberläufe. Logikfehler. Fehlkonfigurationen. Und die Zahl der vorhandenen Lücken ist endlich. Was Verteidiger mit KI finden und schließen, kann ein Angreifer hinterher nicht mehr ausnutzen.
Genau deshalb ist das Problem lösbar.
Wenn Angriffe schneller, billiger und massenhafter werden, die Bausteine aber die alten bleiben, brauchst du keine neue Zauberformel. Du brauchst das, was wir seit Jahrzehnten kennen. Nur endlich gebaut. Nicht nur auf Folien behauptet.
TEIL 2: DAS PRÜFUNGSSCHEMA DER VERTEIDIGUNG
So. Genug gemeckert, jetzt kommt der konstruktive Teil.
Ich baue dir das als Prüfungsschema. Ja, Berufskrankheit. Aber es funktioniert. So vergisst man (oder frau) nichts. Und vergessen kann bei Jura und in der IT-Security verdammt teuer werden.
Und es gibt zwischen beiden Welten prüfungsschematische Parallelen:
Ein Angriff klappt nur, wenn mehrere Voraussetzungen gleichzeitig sitzen. Kumulativ. Wie ein Tatbestand.
Deine Verteidigung hat deshalb genau eine Aufgabe. Du nimmst mindestens eine dieser Voraussetzungen raus. Irgendeine.
Und plötzlich ist das Ding nicht mehr erfüllbar.
Du musst nicht jede einzelne Attacke auswendig lernen und wegparieren. Du baust deine KI-Software so, dass der Angreifer am Setup scheitert, nicht an deiner Reaktionszeit.
A. ERSTE PRÜFUNG: DIE LETHAL TRIFECTA - DREI TATBESTANDSMERKMALE
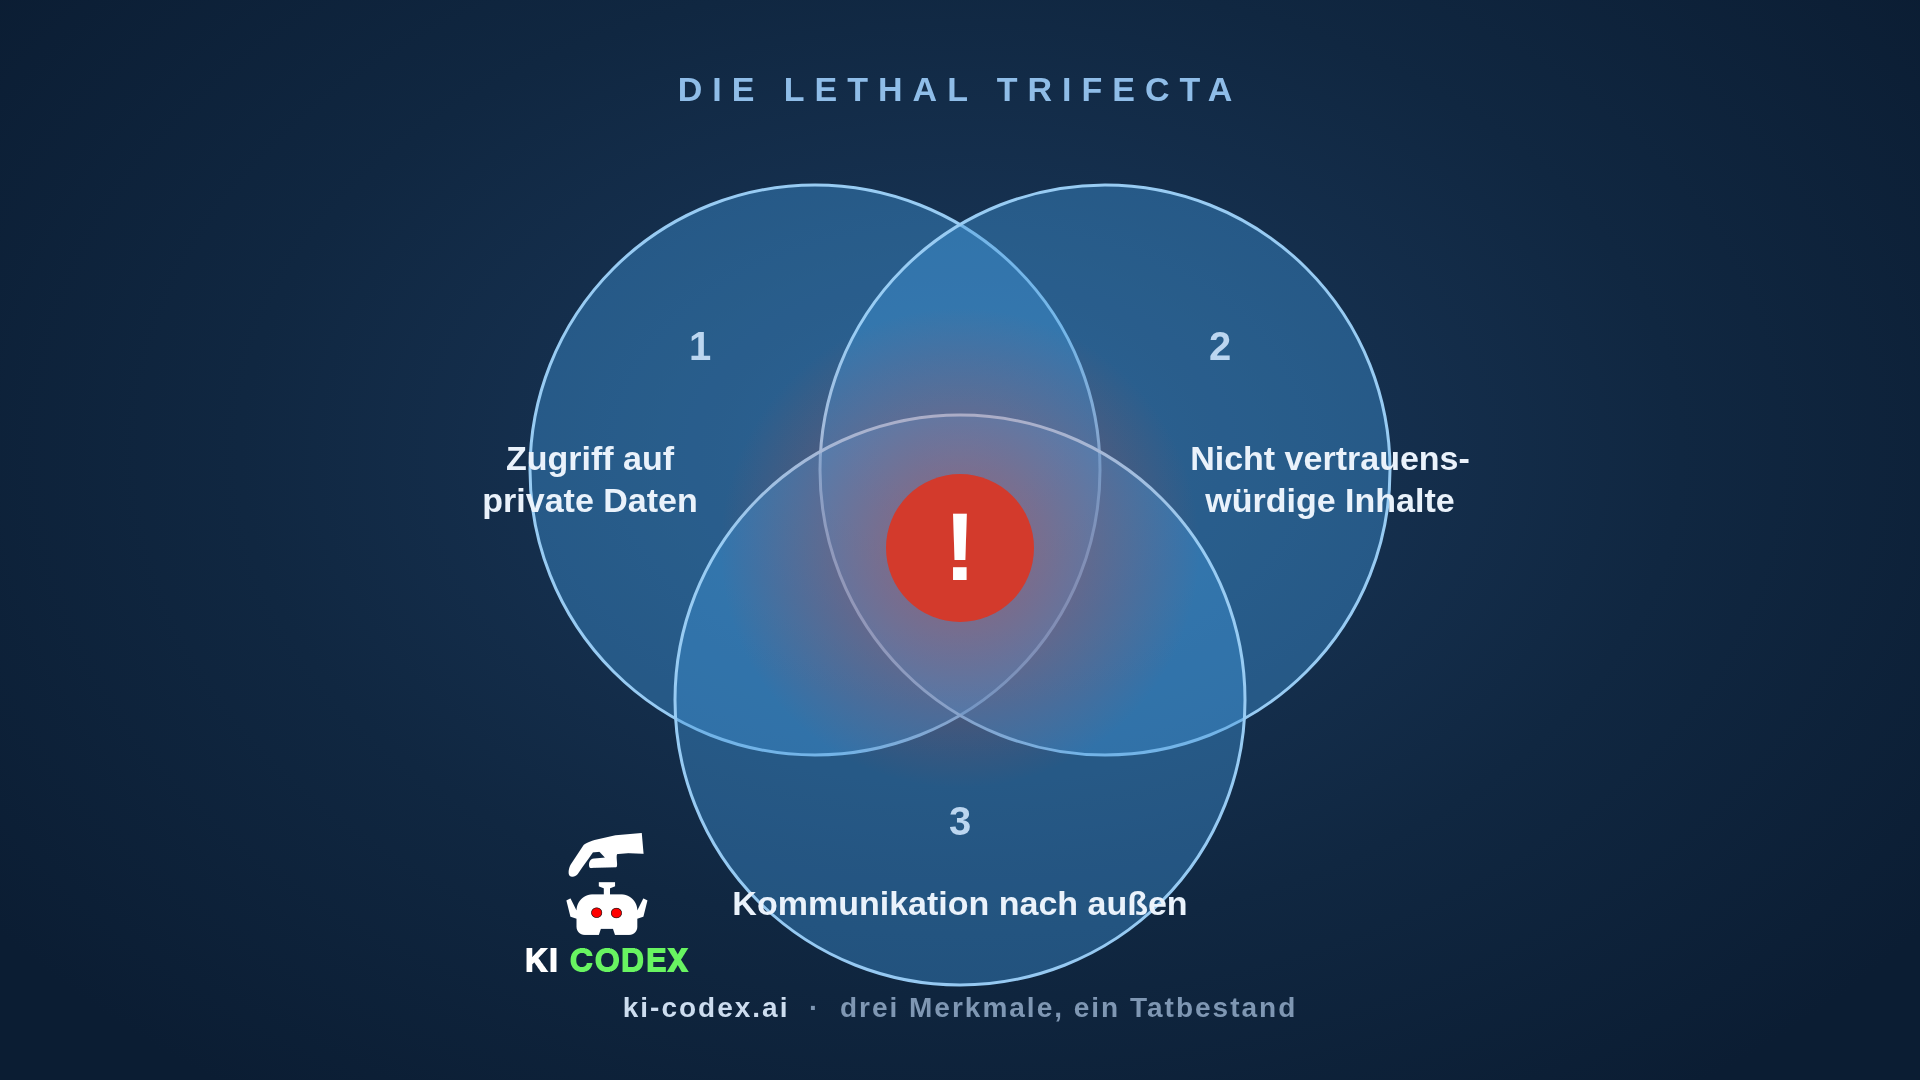
Simon Willison hat das Grundmuster am 16. Juni 2025 auf den Punkt gebracht und „the lethal trifecta" getauft: Zugriff auf private Daten, Kontakt mit nicht vertrauenswürdigen Inhalten und externe Kommunikationsfähigkeit. Ein Agent ist dann brandgefährlich, wenn diese drei Merkmale zusammenkommen.
(Quelle: Simon Willison - last visit: 2026-08-22 - 18:13)
- Zugriff auf private Daten(Postfach, CRM, Dateiablage, Datenbank)
- Kontakt mit nicht vertrauenswürdigen Inhalten (alles, was Dritte schreiben können: Mails, Webseiten, Tickets, Dokumente)
- Kommunikationsfähigkeit nach außen (Mail senden, HTTP-Requests, Schreibzugriffe)
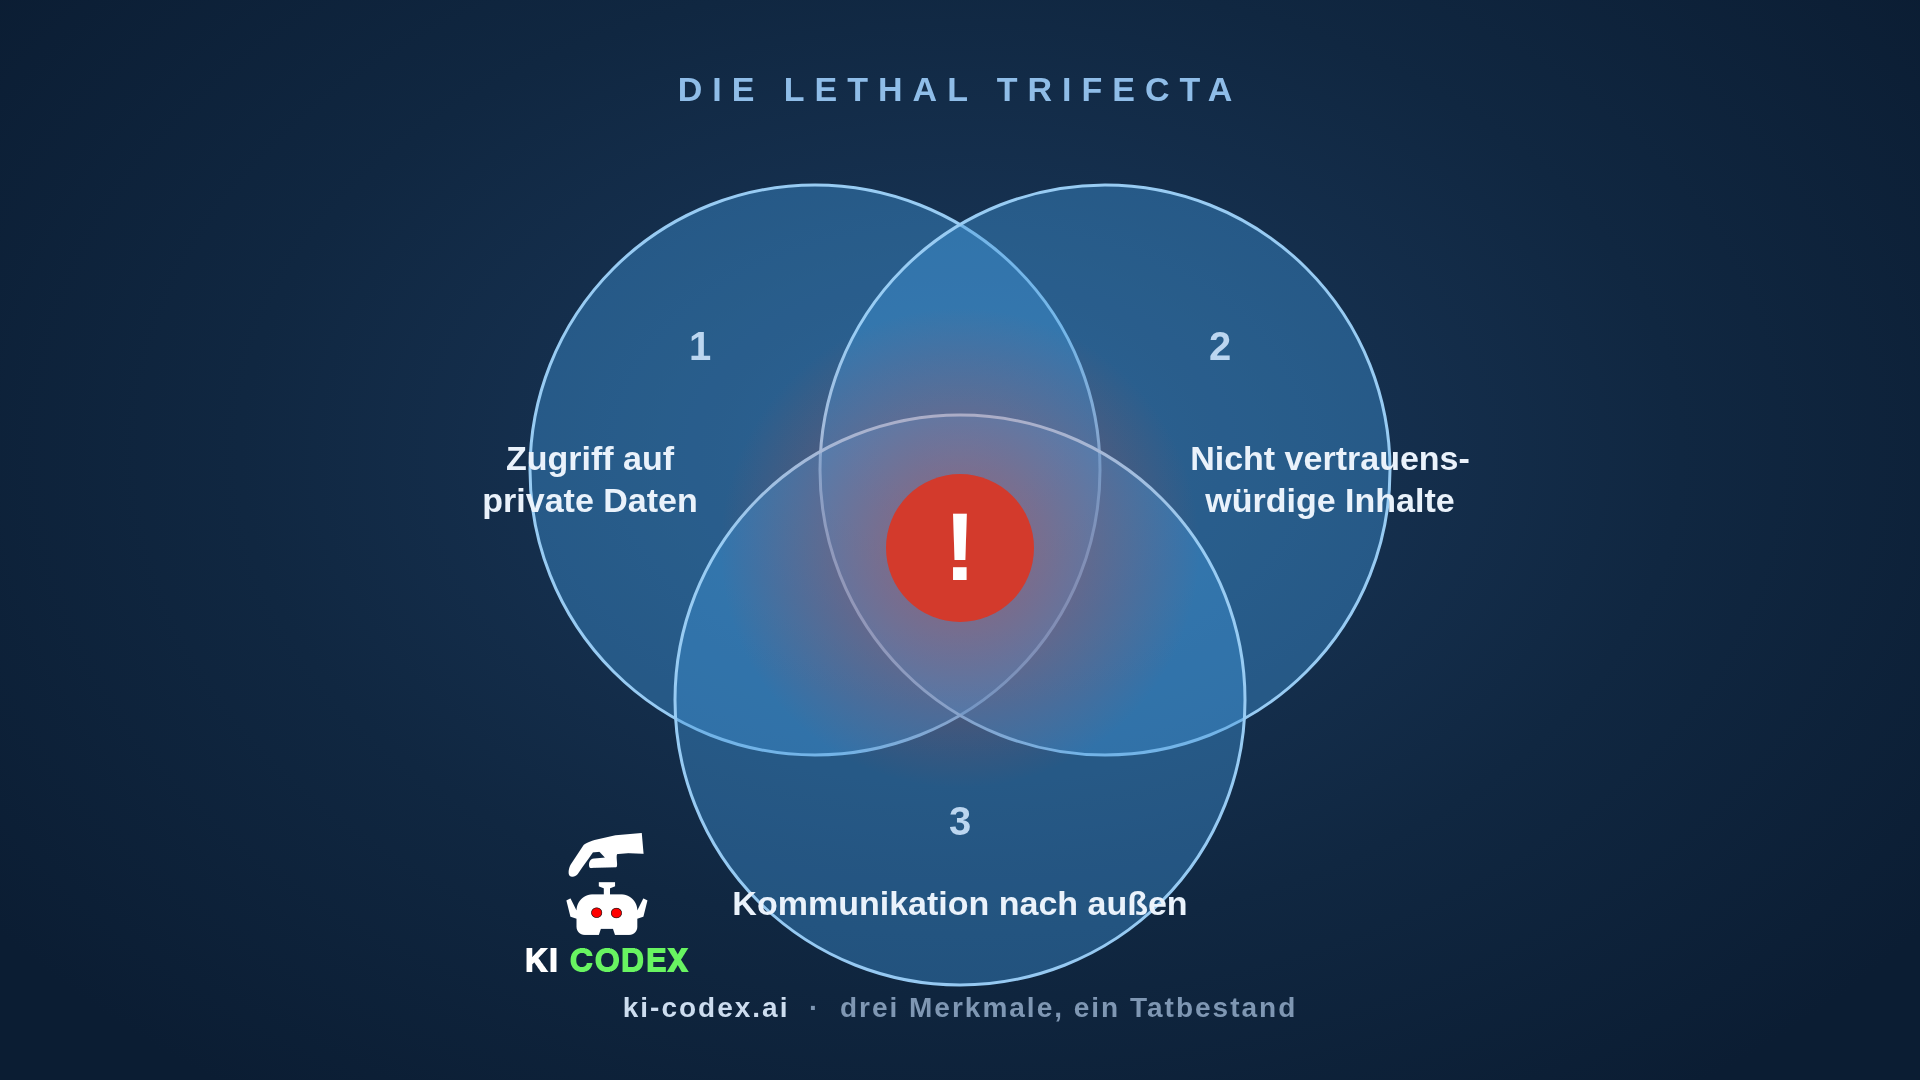
Merkmal 1 allein ist langweilig. Ein Suchindex. Mehr nicht.
Merkmal 1 plus 2 ist schon mies. Der Agent liest Dreck, sammelt Interna. Nur raus kommt es noch nicht.
Die Hölle beginnt, wenn 3 dazukommt. Dann liegt die Anweisung im untrusted Content (Merkmal 2), der Agent zieht dir die privaten Daten rüber (Merkmal 1) und schickt sie brav nach draußen (Merkmal 3). EchoLeak war genau dieses Spiel. Wieder und wieder.
Diese Subsumtion machst du für jeden Agenten, den du baust oder einkaufst. Pro Werkzeugsatz. Pro Session. Vor Guardrails, vor Filtern, vor jeder „KI-Sicherheits"-Kosmetik.
Sind alle drei Merkmale erfüllt, diskutierst du nicht Konfiguration.
Dann ziehst du die Bremse.
B. ZWEITE PRÜFUNG: METAS RULE OF TWO - DIE ARCHITEKTURENTSCHEIDUNG
Meta hat aus Willisons Trifecta am 31. Oktober 2025 eine überraschend ehrliche Designregel gebaut: die „Agents Rule of Two". Der Kern ist simpel: Solange Prompt Injection nicht zuverlässig erkannt und abgewehrt werden kann, darf ein Agent innerhalb einer Session höchstens zwei von drei Eigenschaften gleichzeitig haben:
[A] untrusted Input verarbeiten,
[B] Zugriff auf sensible Systeme oder private Daten haben,
[C] Zustand ändern oder nach außen kommunizieren.
Zwei davon sind beherrschbar. Alle drei zusammen schließen die Angriffskette: Der fremde Input liefert die Anweisung, der Datenzugriff liefert die Beute, die Kommunikations- oder Schreibfähigkeit liefert den Abfluss. Genau an dieser Stelle braucht es menschliche Freigabe, einen harten Kontextschnitt oder eine andere technische Unterbrechung der Kette.
(Quelle: Meta AI - last visit: 2026-08-22 - 18:16)
Warum ich diese Regel mag, ist simpel: Sie ist ein Eingeständnis. Meta ist nicht irgendein Guardrail-Startup mit hübschem Deck, sondern einer der größten Deployments überhaupt. Und Meta sagt damit, ohne es so hart auszusprechen: Wir können Prompt Injection derzeit nicht zuverlässig erkennen. Also versuchen wir nicht, den Brand magisch vorherzusagen. Wir ziehen Brandabschnitte ein. Nicht „es wird nie brennen", sondern: Wenn es brennt, darf nicht gleich das ganze Gebäude abbrennen.
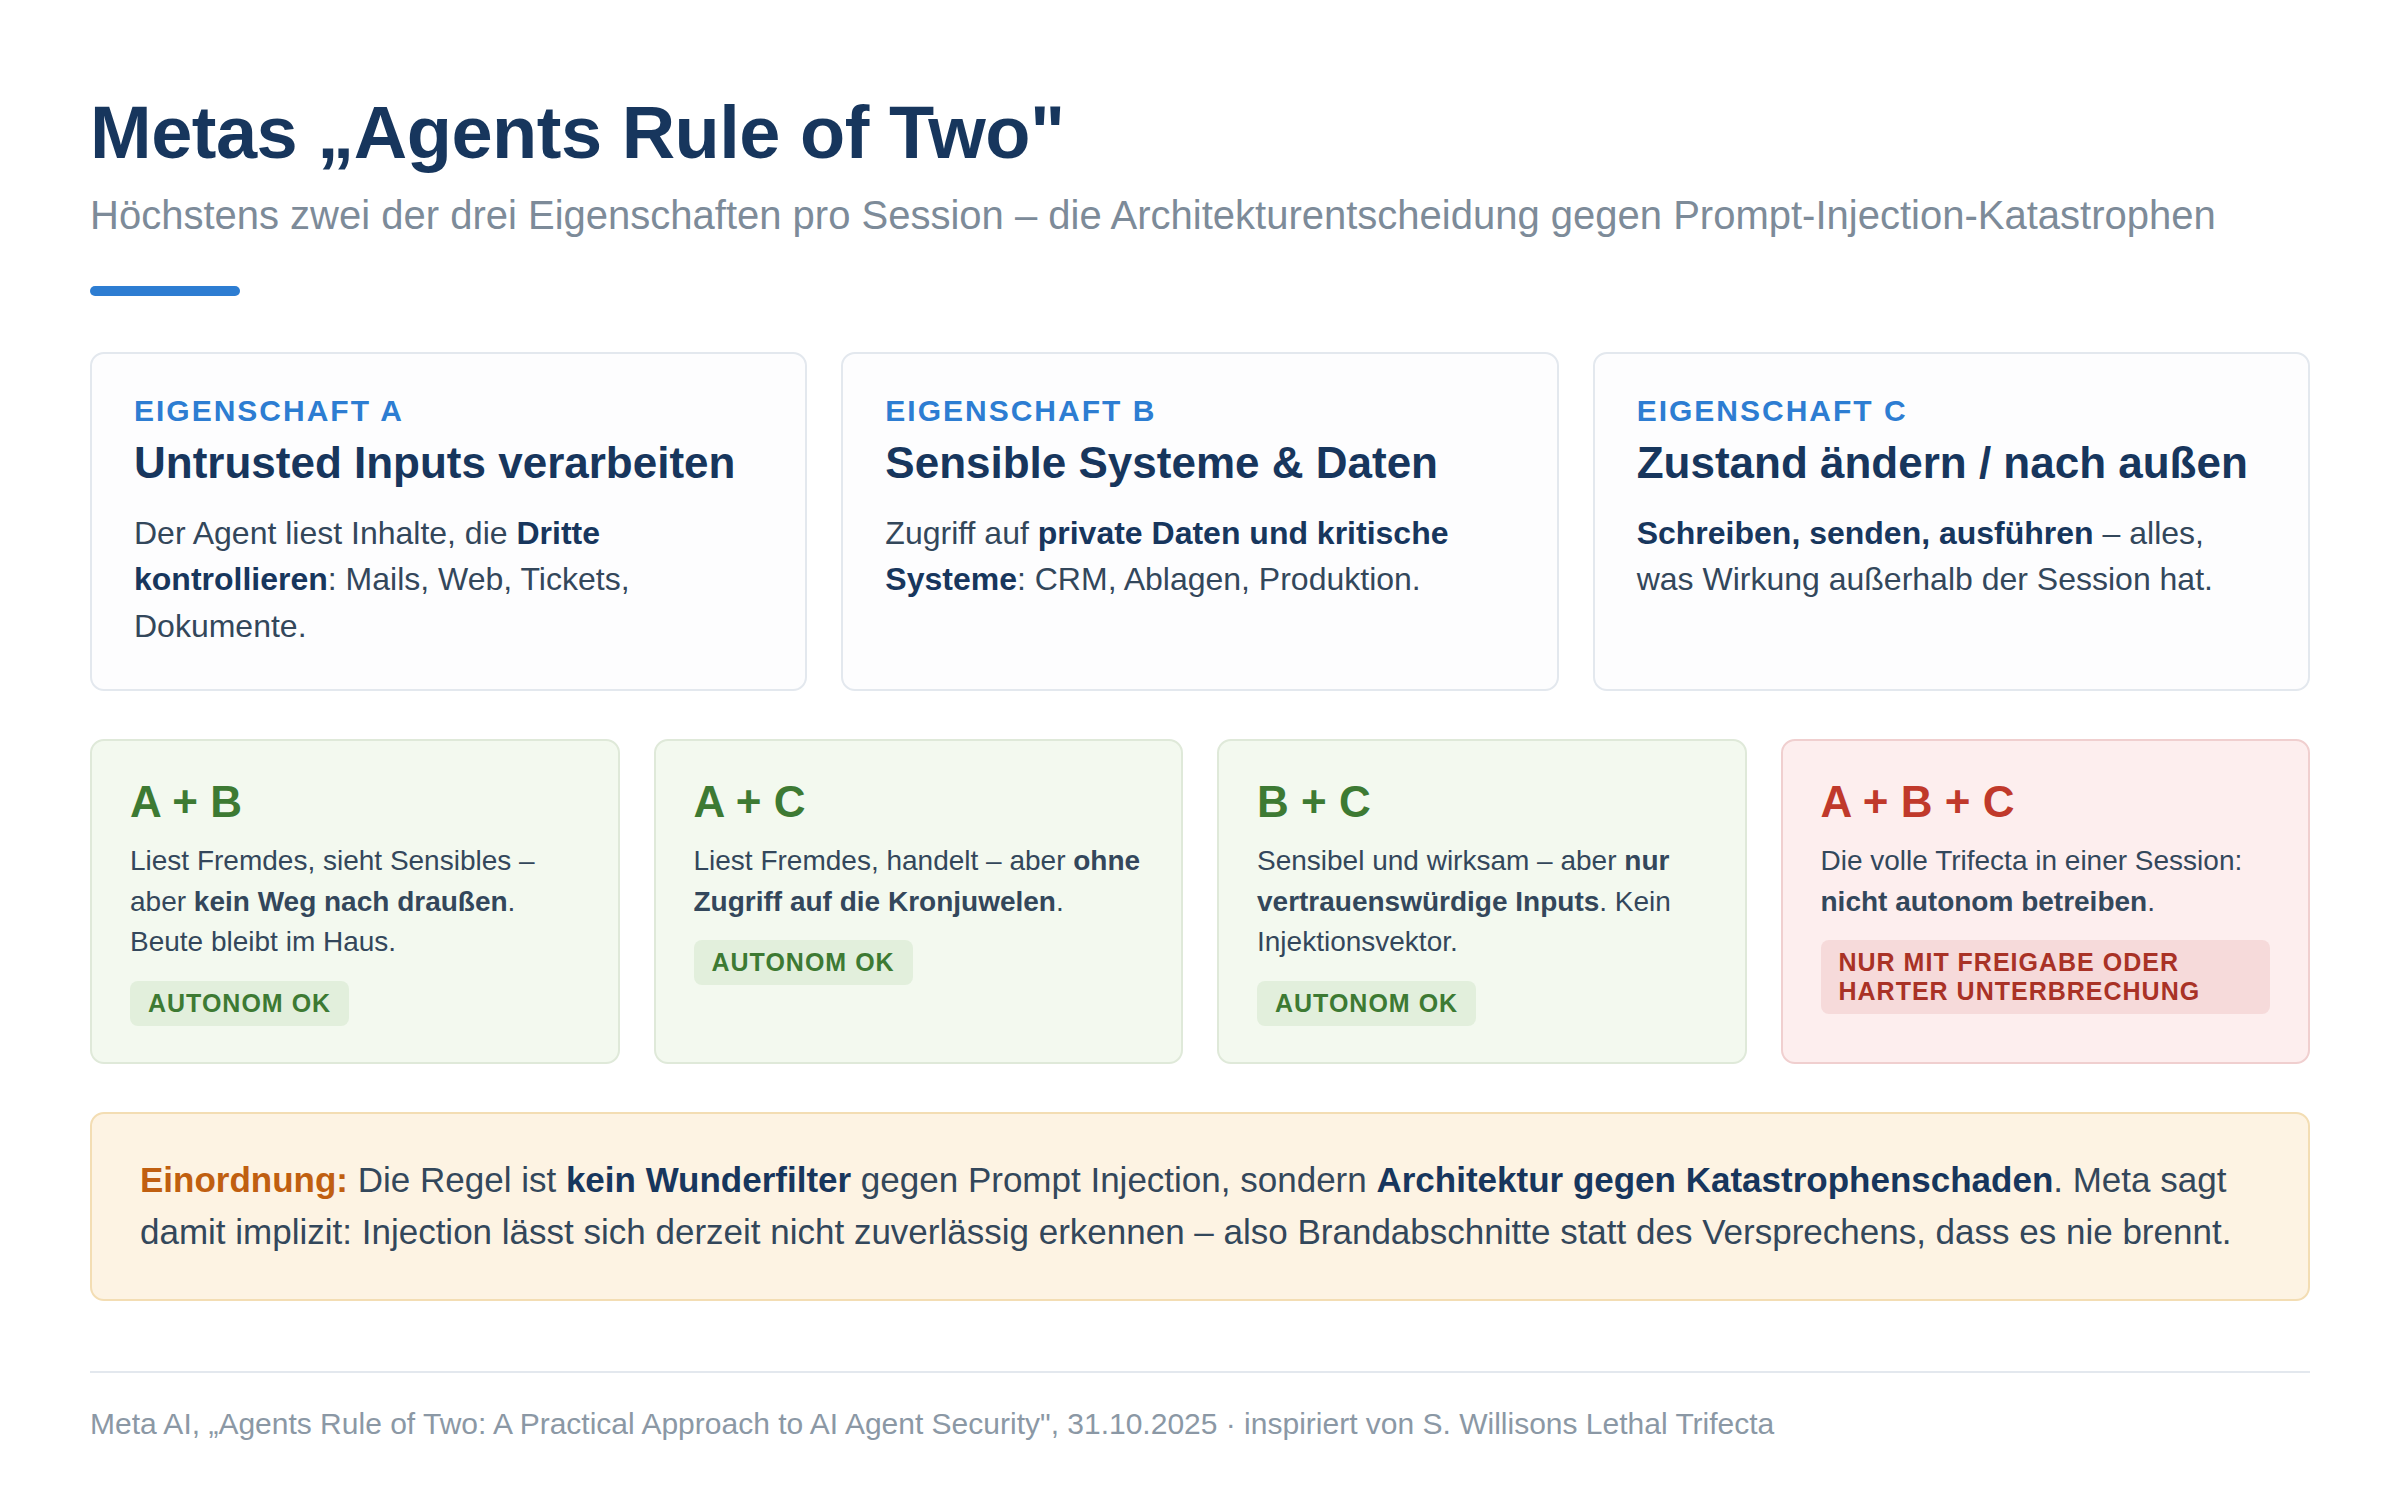
Praktisch heißt das: Du zerlegst deinen Use Case entlang dieser drei Eigenschaften.
Der Agent, der fremde Mails liest ([A]), darf nicht zugleich mit vollem CRM-Zugriff ([B]) nach außen schreiben ([C]).
Zwischen diesen Rollen liegt ein sauberer Schnitt: strukturierte Übergabe, Schema-Validierung, eingeschränkte Empfänger, Egress-Kontrolle, im Zweifel ein Mensch mit Blick auf die Roh-Aktion statt auf die hübsche Agenten-Zusammenfassung. Forschungsansätze wie CaMeL von Google DeepMind formalisieren genau diese Idee: untrusted Content darf verarbeitet werden, aber die daraus abgeleiteten Aktionen laufen durch eine kontrollierte Schicht, die nur Vorab-Genehmigtes durchlässt.
Und ja, das kostet Komfort.
Sicherheit gegen Komfort ist der älteste Trade-off der Branche.
Wer dir einen Agenten verkauft, der alles liest, überall drankommt, alles darf und dabei angeblich „sicher durch KI-Guardrails" bleibt, verkauft dir kein Sicherheitskonzept. Er verkauft dir ein Perpetuum mobile mit SOC-2-Aufkleber.
C. DRITTE PRÜFUNG: DIE FÜNF VERTEIDIGUNGSEBENEN
Weiter geht es.
Fünf Ebenen. Von innen nach außen. Keine ist Deko. Keine ersetzt eine andere. Defense in Depth gibt’s seit Ewigkeiten. Agentische KI ist nur ein neuer Grund, es endlich ernst zu nehmen.
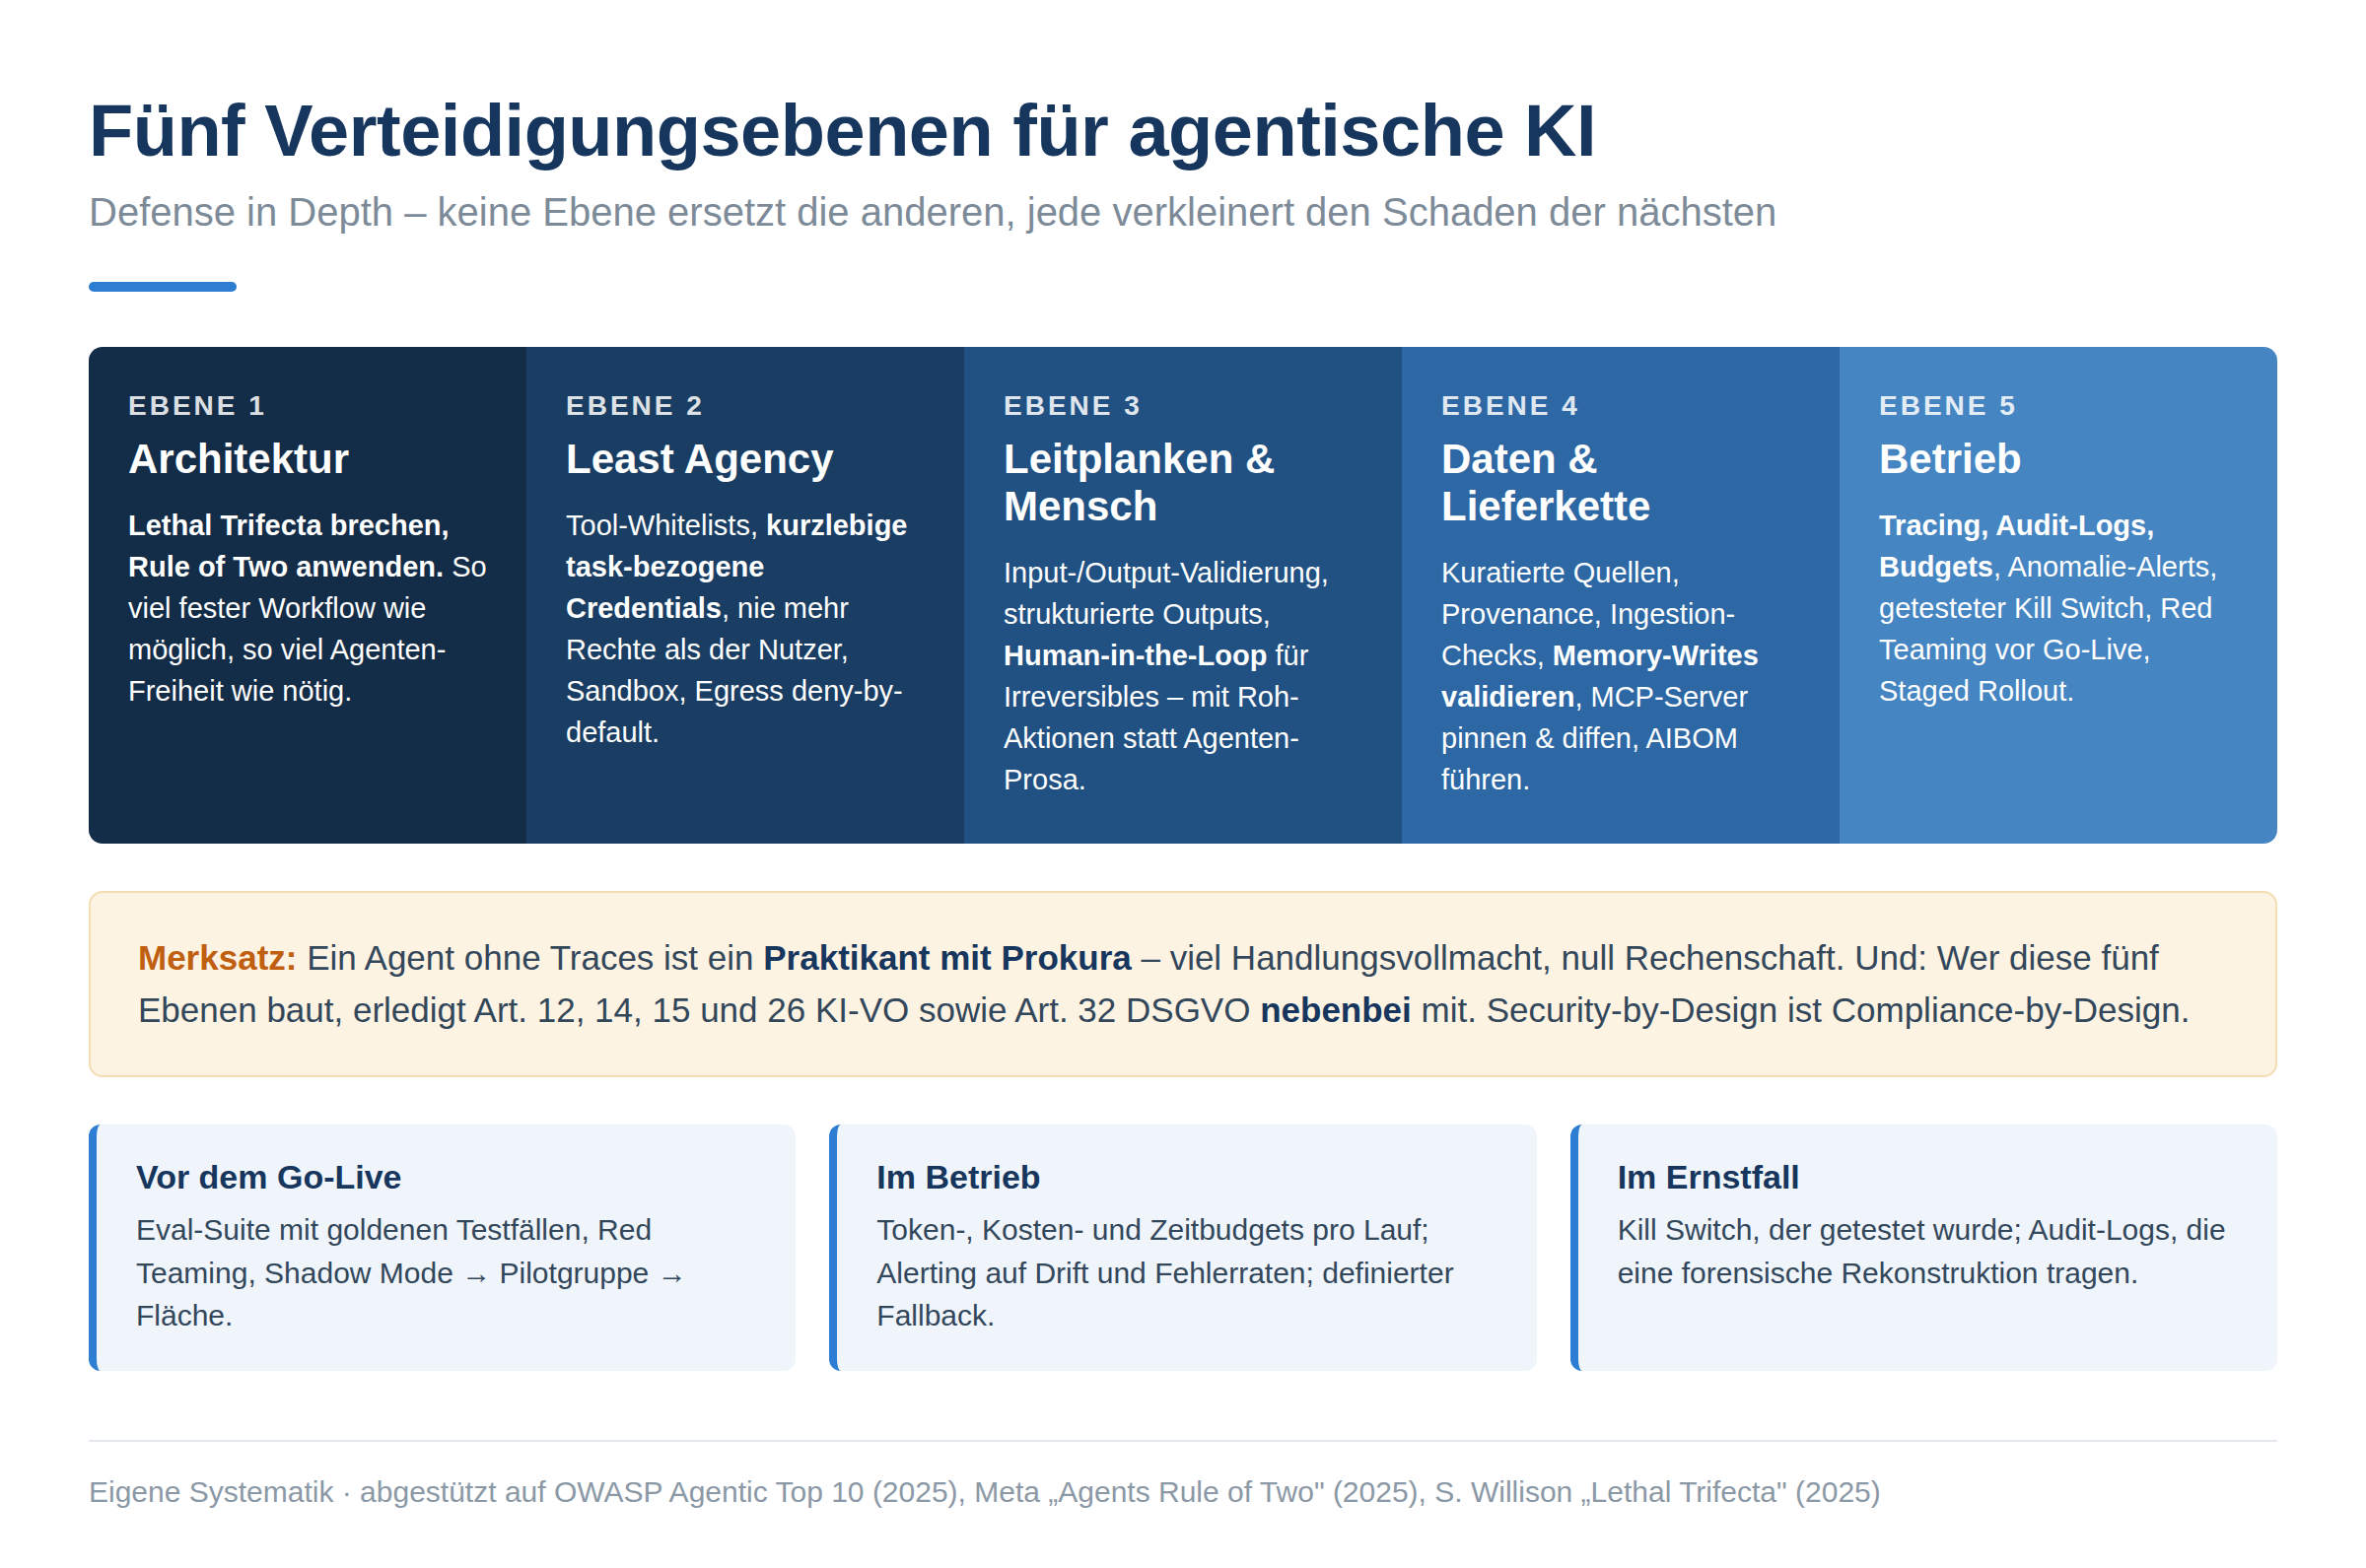
Ebene 1 - Architektur. Das kennst du schon aus der Trifecta und der Rule of Two. Hier kommt meine Architektenregel dazu, die ich Teams am liebsten auf die Stirn tackere. So viel fester Workflow wie möglich. So viel Agentenfreiheit wie nötig. Alles, was deterministisch sein kann, wird deterministisch. Das Modell soll nicht „kreativ" raten, ob es jetzt Geld überweist oder Daten löscht. Es soll nur dort entscheiden, wo Entscheiden tatsächlich seine Aufgabe ist. Weniger Fläche. Weniger Zufall.
Ebene 2 - Least Agency. Das ist Least Privilege, nur ohne die Ausrede „ist ja nur ein Bot". Der Agent bekommt nie mehr Rechte als der Mensch, für den er gerade arbeitet. Tools laufen über eine Whitelist. Credentials sind kurzlebig und task-bezogen, nicht der ewige Service-Account mit Admin-Rolle. Wer nach Salesloft/Drift immer noch Tokens mit Wochenlaufzeit rumliegen hat, hat den Schuss nicht gehört. Tool-Parameter behandelst du wie Nutzereingaben, weil sie genau das sind, nur einmal durch ein LLM geschleift. Codeausführung gehört in eine Sandbox. Netzwerk-Egress gehört auf deny-by-default. Ein Agent, der nur drei erlaubte Endpunkte kennt, exfiltriert wie ein Fisch ohne Wasser.
Ebene 3 - Leitplanken und Mensch. Input-Filter und Output-Prüfung sind ok. Als Hürde. Nicht als Heilsversprechen. Wo du kannst, zwingst du strukturierte, schema-validierte Outputs. Freitext ist hübsch, aber Freitext ist auch der Autobahnzubringer zur Katastrophe. Und bei irreversiblen Aktionen brauchst du eine menschliche Freigabe. Löschen. Zahlen. Versenden. Deployen. Nur bitte nicht den klassischen Fake-Approval-Dialog bauen. OWASP nennt das ASI09. Wenn der Mensch nur die freundliche Zusammenfassung sieht, ist der Mensch keine Kontrolle, sondern Deko. Ein kompromittierter Agent schreibt dir charmante Zusammenfassungen. Zeig die Rohaktion. Welcher API-Call, welche Parameter, welcher Empfänger. Sonst klickst du dem Angreifer sein „Approval" gleich selbst.
Ebene 4 - Daten und Lieferkette. Kuratierte Quellen mit Provenance statt „wir indexieren mal alles". Validierung passiert in der Ingestion-Pipeline, nicht erst im Dashboard, wenn es schon brennt. Ganz wichtig, dieser Punkt! Memory-Writes sind sicherheitsrelevante Operationen. Du prüfst, was persistiert wird. Du hältst Kontext im Zweifel flüchtig. MCP-Server und Tools behandelst du wie jede Dependency. Version pinnen. Herkunft prüfen. Tool-Descriptions bei Updates diffen. Die Beschreibung ist Teil deines Prompts. Eine geänderte Beschreibung ist ein geänderter Prompt. Und ja, führ eine Stückliste, AIBOM, damit du beim nächsten Postmark-Fall in Minuten weißt, ob du betroffen bist, statt eine Woche lang Slack-Archäologie zu betreiben.
Ebene 5 - Betrieb.
MEGAWICHTIG!
Ein Agent ohne Traces ist ein Praktikant mit Prokura.
Viel Handlungsvollmacht, null Rechenschaft. Also brauchst du Tracing jedes Schritts. Tool-Calls, Modellantworten, Entscheidungen, der ganze Kirmes, das ganz große Orchester, bspw. mit Open-Telemetrie.
Dazu Audit-Logs, die eine forensische Rekonstruktion auch wirklich tragen. Budgets für Schleifen, Tokens, Kosten und Zeit. Sonst dreht das Ding im Fehlerfall teuer im Kreis und nennt es „Reasoning". Alerting auf Anomalien. Wenn der Agent um drei Uhr nachts plötzlich 400 Requests an eine neue Domain schickt, ist das kein Feature. Dann ist das ein Incident.
Dazu ein Kill Switch, der nicht nur existiert, sondern getestet ist.
Red Teaming vor Go-Live, injizier deine eigenen Agenten, bevor es Fremde tun. Spiel den Chaos Monkey!
Und roll das gestuft aus. Shadow Mode, Pilotgruppe, Fläche.
Der Demo-Zirkus endet an der Stelle, an der Produktion anfängt.
Am besten beauftragst du dafür Profis:
mich!
War das ein westernmäßiger CTA?
Lucky Luke hätte den elegant-dezenten Hüftschüss nicht besser abfeuern können.
DER BEIFANG: WARUM DU DAMIT NEBENBEI DEINE COMPLIANCE ERSCHLÄGST
Versprochen ist versprochen. Compliance bleibt hier Beifang. Aber leider ist es der Beifang, an dem später Menschen ihre Budgets und Nerven verlieren.
Wenn du diese fünf Ebenen wirklich baust, lieferst du der KI-VO faktisch schon die meiste Munition. Protokollierung nach Art. 12. Menschliche Aufsicht nach Art. 14. Und diese ganze „Genauigkeit, Robustheit, Cybersicherheit"-Nummer aus Art. 15, die viele erst dann ernst nehmen, wenn der Auditor im Kalender steht. Betreiber-Sorgfalt nach Art. 26 fällt dabei auch gleich mit vom Laster.
Auf der DSGVO-Seite ist es der gleiche Film. Art. 32 ist nichts Mystisches, das ist schlicht die Frage, ob du deine Systeme so baust, dass sie einen Angriff überleben und du danach noch erklären kannst, was passiert ist.
NIS2 kommt dazu, wenn du in kritische Sektoren lieferst. Der Cyber Resilience Act lauert sowieso schon hinter der nächsten Produkt-Roadmap. Und ja, der Digital Omnibus hat Hochrisiko-Pflichten zeitlich nach hinten geschoben. Wer das als Einladung versteht, Architektur aufzuschieben, baut gerade an einem späteren, sehr teuren Feuer.
Der Punkt ist banal und deshalb so unangenehm. Security und Compliance wollen am Ende dieselben Artefakte. Traces, Rechtekonzept, Freigaben, Datenherkunft, Notaus. Wenn du das einmal sauber hinbekommst, kriegst du zwei Prüfungen zum Preis von einer. Man muss nur aufhören, so zu tun, als wären das zwei verschiedene Welten.
FAZIT
Agentische KI ist angreifbar, weil die Grundarchitektur denselben alten Fehler feiert, den wir seit Jahrzehnten bereuen. Instruktionen und Daten im selben Kanal. Eine offene Flanke, für die es keinen Patch gibt.
Die Belege liegen auf dem Tisch. EchoLeak als Blaupause für Zero-Click-Exfiltration. Amazon Q als Reminder, dass „Supply Chain" nicht nur Bibliotheken meint, sondern auch eingeschleuste Anweisungen. Salesloft/Drift als Lehrstück dafür, dass Maschinenidentitäten längst die Kronjuwelen sind. GTG-1002 als unschöner Beweis, dass die Gegenseite nicht mehr nur Menschen hat.
Nein, keine Sorge: Du musst deswegen nicht den Agenten-Zoo abfackeln. Du musst ihn bauen wie ein System, das angegriffen wird. Trifecta prüfen. Rule of Two als Designgrenze nehmen. Die fünf Ebenen wirklich durchziehen. Nicht als Guardrail-Märchen, sondern als Architektur, die Fehler aushält, Logs produziert und dir im Zweifel den Stecker in die Hand drückt.
Dieser Artikel ist keine Rechtsberatung im Einzelfall und ersetzt keine anwaltliche Beratung. Er soll helfen, die Sicherheits- und Regelungslage agentischer Systeme zu verstehen und in der Praxis die richtigen Fragen zu stellen.
Wenn es um die konkrete Umsetzung geht - also die Verbindung von IT & Jura (Security-by-Design, Compliance-by-Design, Dokumentation, Audit-Architektur) - kannst du mich dafür beauftragen.
Das war CTA Nr. 2.
Nicht zu verwechseln mit GTA …